
1. はじめに
背景
データエンジニアリングシステムでは、ETLパイプラインを構築するだけでは十分ではありません。ランタイムエラーが発生せず、技術的には正常に実行されたパイプラインであっても、レコードの欠落、キーの重複、想定外のNULL値、マイナスの数値といった誤ったデータが生成される可能性があります。
しかし、現在でも多くのシステムではログの監視のみでとどまり、自動アラートの仕組みがなく、手動での確認に依存しています。そのため、データの誤りはエンドユーザーが誤ったレポートを既に利用した後に発覚することが少なくありません。
Azure Databricksでは、Lakeflow JobsのSQLアラートタスクが提供されており、Databricks SQLアラートをワークフロー内に直接組み込むことができます。これにより、データ処理の各ステップの完了後に、条件確認用クエリーを自動的に実行し、問題が検知された時点で通知を送信できます。
目的
本記事では、SQLアラートタスクを使用して、ジョブ内でSQLクエリーによるデータ品質チェックを自動化する方法を説明します。また、データが業務上の条件に違反した際に受信者へタイムリーにアラートを送信する方法、およびETL処理の各ステップとデータ品質チェックのステップを1つのジョブに集約して一元管理する方法についても解説します。
ゴール
本記事を読み終えると、Databricks SQLアラートの作成、ジョブへのSQLアラートタスクの追加、ジョブからアラートへのパラメーターの引き渡しを行えるようになります。また、タスクによるアラート評価の仕組み、およびタスクのステータスが示す意味についても理解できるようになります。
さらに、本記事では、実際の運用環境に適用する際の制限事項、実行時のID、および必要な権限についてもまとめています。
2. Lakeflow JobsにおけるSQLアラートタスクの概要
SQLアラートタスクは、Lakeflow Jobsのタスクの一種であり、Databricks SQLアラートをワークフローの1つのステップとして評価するため使用されます。
タスクが実行されると、DatabricksはSQLウェアハウス上でアラートのクエリーを実行し、その結果を設定済みの条件と比較します。そして、評価結果に基づいて受信者へ通知を送信します。
SQLアラートタスクの主な構成要素
- Databricks SQLアラート:SQLクエリー、トリガー条件、および通知設定で構成されます。タスクを追加する前に、アラートを作成しておく必要があります。
- SQLウェアハウス:アラートのクエリーを実行するコンピュートです。サーバーレスまたはProタイプのSQLウェアハウスのみサポートされます。
- サブスクライバー:任意の設定項目です。ユーザーや、Email、Slack、Microsoft Teams、Webhookなどの通知先がアラートの評価結果を受け取ります。未設定の場合は、アラート側で設定された受信者に通知されます。これは、タスクの開始時、完了時、または失敗時のみを通知する、タスクの「通知」とは異なります。
- パラメーター:アラートのクエリーパラメーターに渡す値です。ジョブパラメーターを参照することもできます。
本記事では、売上データを読み込むETLステップと、読み込み後のデータをチェックするSQLアラートタスクで構成されるジョブを作成します。その後、正常なデータと異常データを使用してそれぞれテストを実行してタスクの動作を確認します。
2.1. Databricks SQLアラートとは?レガシーアラートとの比較
Databricks SQLアラートは、定期的またはオンデマンドでクエリーを実行し、その結果に対して条件を評価します。条件が満たされた場合、通知が送信されます。
最新バージョンでは、統一されたインターフェース上でアラートの作成と管理が一元的に行えるようになっています。以下の表で、最新バージョンとレガシーアラートを比較します。
| 項目 | Databricks SQLアラート(最新) | レガシーアラート |
|---|---|---|
| 作成方法 | クエリーの作成、条件・通知・スケジュールの設定を1つの画面で行う | 先にクエリーを作成・保存し、そのクエリーをもとにアラートを作成する |
| 評価ステータス | OK、TRIGGERED、ERROR | OK、TRIGGERED、UNKNOWN |
| ジョブでのタスク種類 | 「SQLアラート」タスク | 「レガシーアラート」タスク |
| SQLアラートタスクでの利用 | 可 | 不可 |
移行期間中は、両方のバージョンを併用できます。「アラート」ページでは、最新のアラートとレガシーアラートが別々のタブに分けて表示されます。
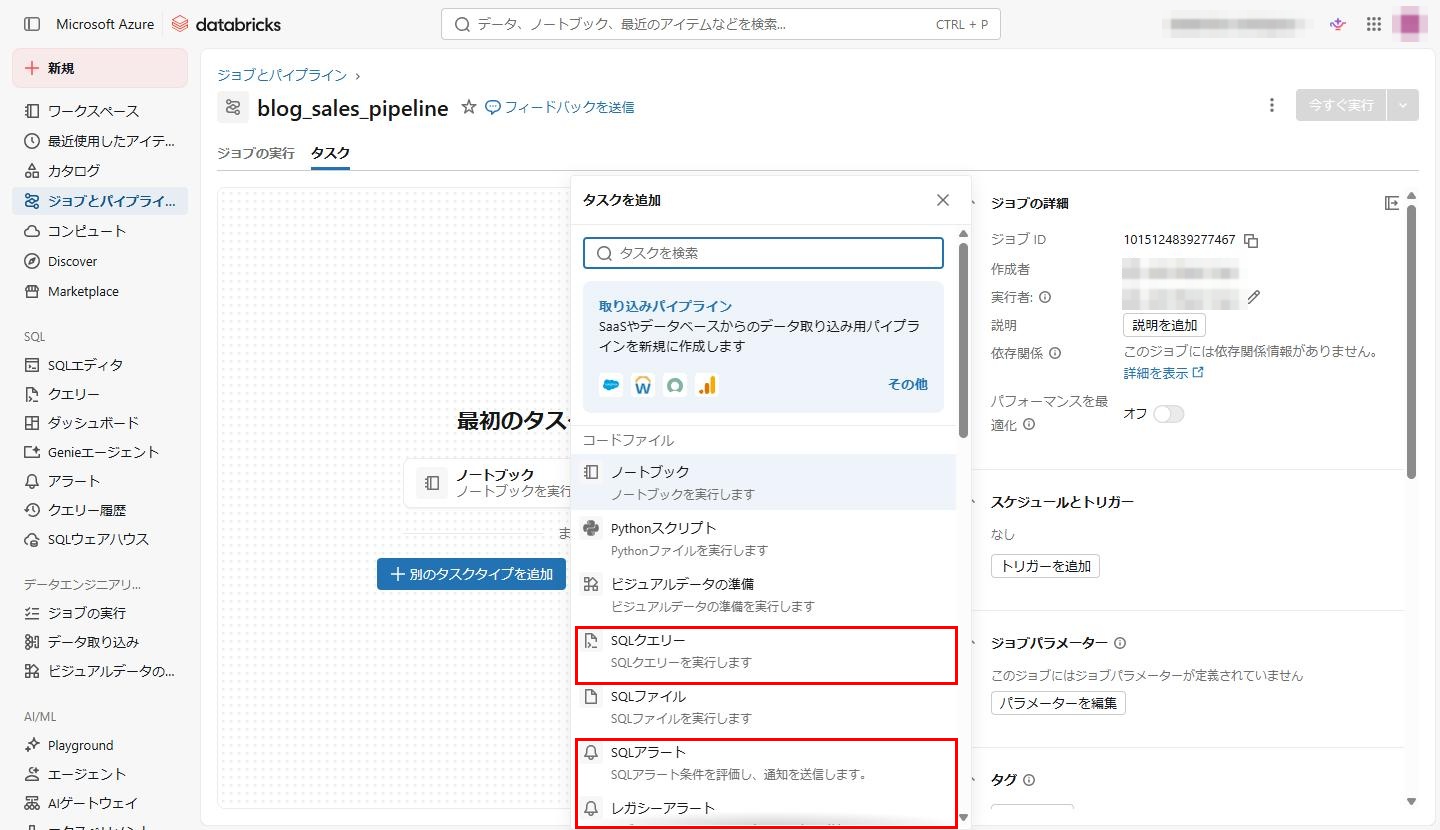
ジョブにタスクを追加する際、タスクの種類一覧には「SQLアラート」と「レガシーアラート」の両方が表示されます。
「SQLアラート」は最新のDatabricks SQLアラートを評価するために使用され、本記事で取り上げる対象です。一方、「レガシーアラート」は、既存のレガシーアラートに使用するためのものです。
2.2. データ監視パイプラインにおけるSQLアラートタスクの役割
ETLステップの直後にSQLアラートタスクを配置することで、パイプラインが実行されるたびにデータ品質チェックが自動的に実施できます。以下の図は、本記事で使用するジョブの構成を示しています。
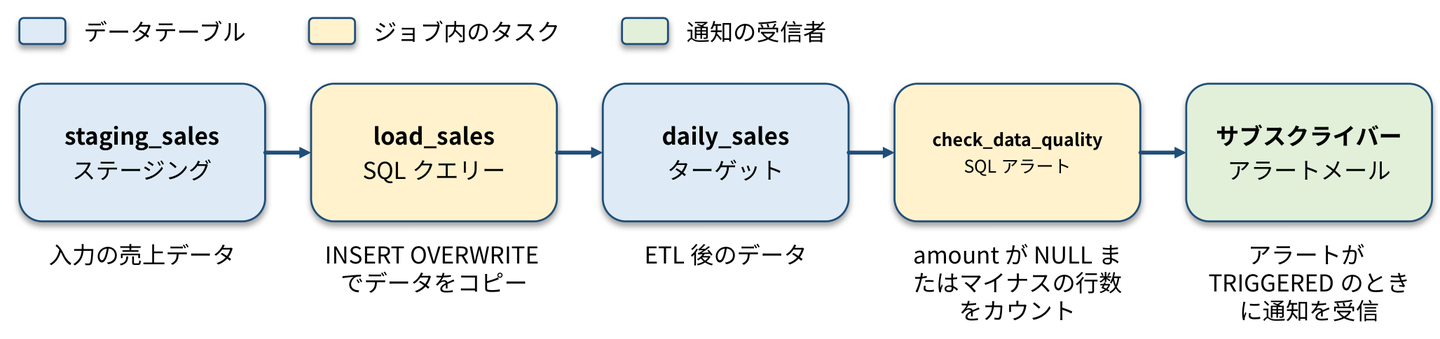
- ランタイムログでは検知できないデータのロジック上の問題を検知できます。
- アラート独自のスケジュールに依存せず、データ更新の直後という適切なタイミングでチェック用クエリーを実行できます。
- ETLの実行履歴とデータチェックの結果を、同じジョブ内で一元管理できます。
3. 前提条件
本記事の手順を実施するには、以下の条件を満たしている必要があります。
- Unity Catalogが有効化されたAzure Databricksワークスペースを使用できること。また、サンプルデータを作成するカタログに対して「USE CATALOG」および「CREATE SCHEMA」の権限を持っていること。本記事では「democatalog」カタログを使用します。
- サーバーレスまたはProタイプのSQLウェアハウスを使用する権限を持っていること。SQLアラートタスクはクラシックタイプのSQLウェアハウスをサポートしていません。
- ワークスペース内でジョブを作成する権限、およびタスクで使用するアラートに対して最低限の「CAN RUN」権限を持っていること。
- Slack、Microsoft Teams、またはWebhookに通知を送信するには、ワークスペース管理者が事前に通知先を作成しておく必要があります。本記事ではメール通知を使用します。
- サンプルデータ用のSQLファイル「setup_sample_data.sql」をこちらからダウンロードしてください。
上記の権限は、本手順を実施する作業者に必要な権限です。本記事では、ジョブの作成者がクエリーとアラートの所有者であり、ジョブの実行時のIDも兼ねています。
実際の運用環境に適用する場合は、ジョブの実行時のIDと、そのIDに付与する権限を別途設計する必要があります。詳しくは「4.7」項を参照してください。
詳細については、以下のドキュメントを参照してください。
・SQL alert task for jobs – Azure Databricks | Microsoft Learn
・Databricks SQL alerts – Azure Databricks | Microsoft Learn
4. SQLアラートタスクの使用手順
4.1. サンプルデータの準備およびデータ品質確認用クエリーの実行
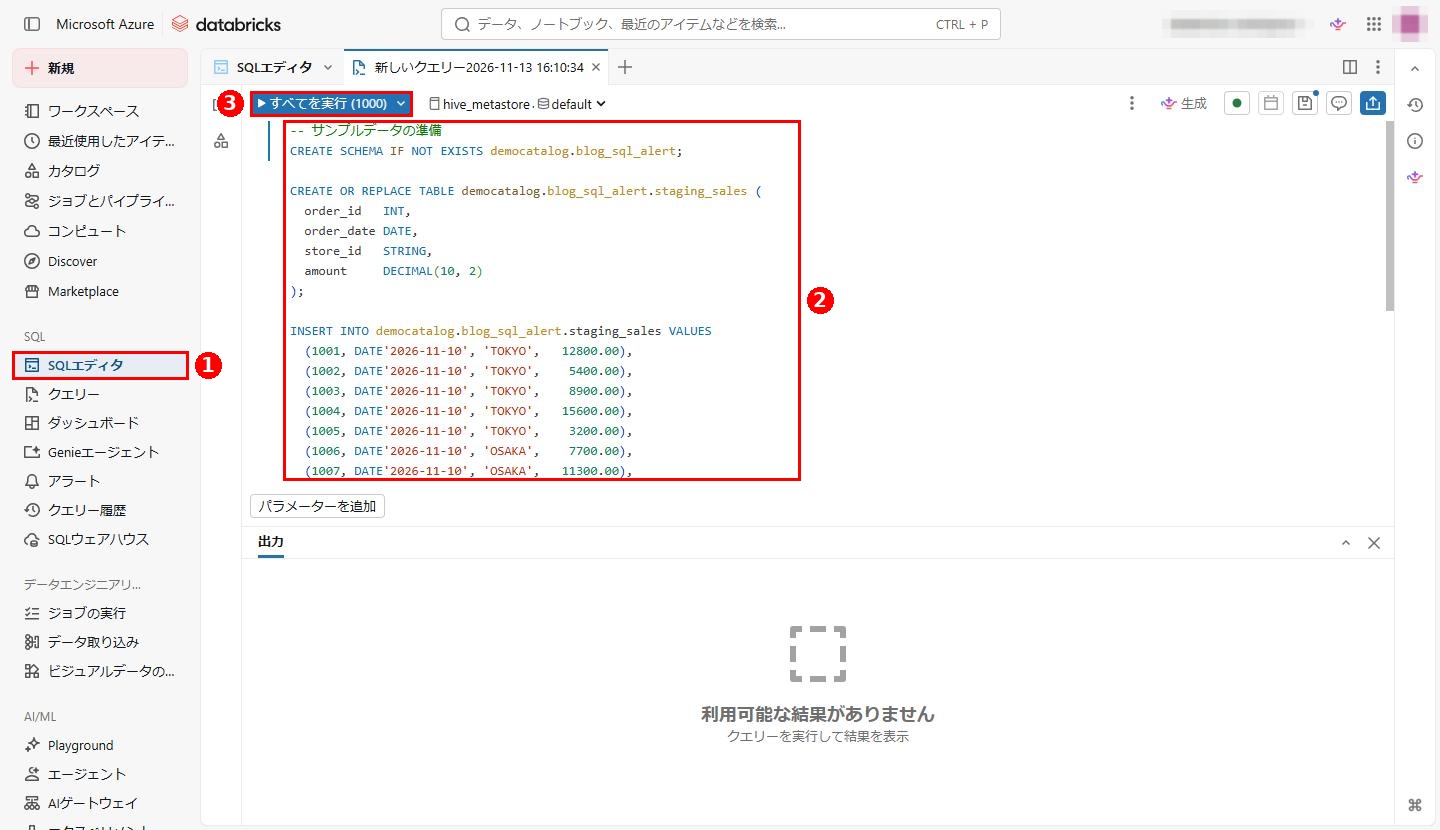
まず、売上データを格納するステージングテーブルと、ETLのターゲットテーブルを作成します。
1. サイドバーで「SQLエディタ」項目を選択し、新しいクエリーを開いてSQLウェアハウスに接続します。
2. 3章の前提条件でダウンロードした「setup_sample_data.sql」を開き、その内容をすべてエディターに貼り付けます。
3. 「すべてを実行」タブをクリックします。
このファイルを実行すると、以下が作成されます。
・「blog_sql_alert」スキーマ
・2026-11-10のデータを20行格納した「staging_sales」ステージングテーブル
・「daily_sales」空のターゲットテーブル
以下のコードはテーブル構造を示すための抜粋であり、実行用ではありません。
|
1 2 3 4 5 6 7 |
-- schema: democatalog.blog_sql_alert CREATE OR REPLACE TABLE staging_sales ( order_id INT, order_date DATE, store_id STRING, amount DECIMAL(10, 2)); -- daily_sales:同じ構造の空テーブル |
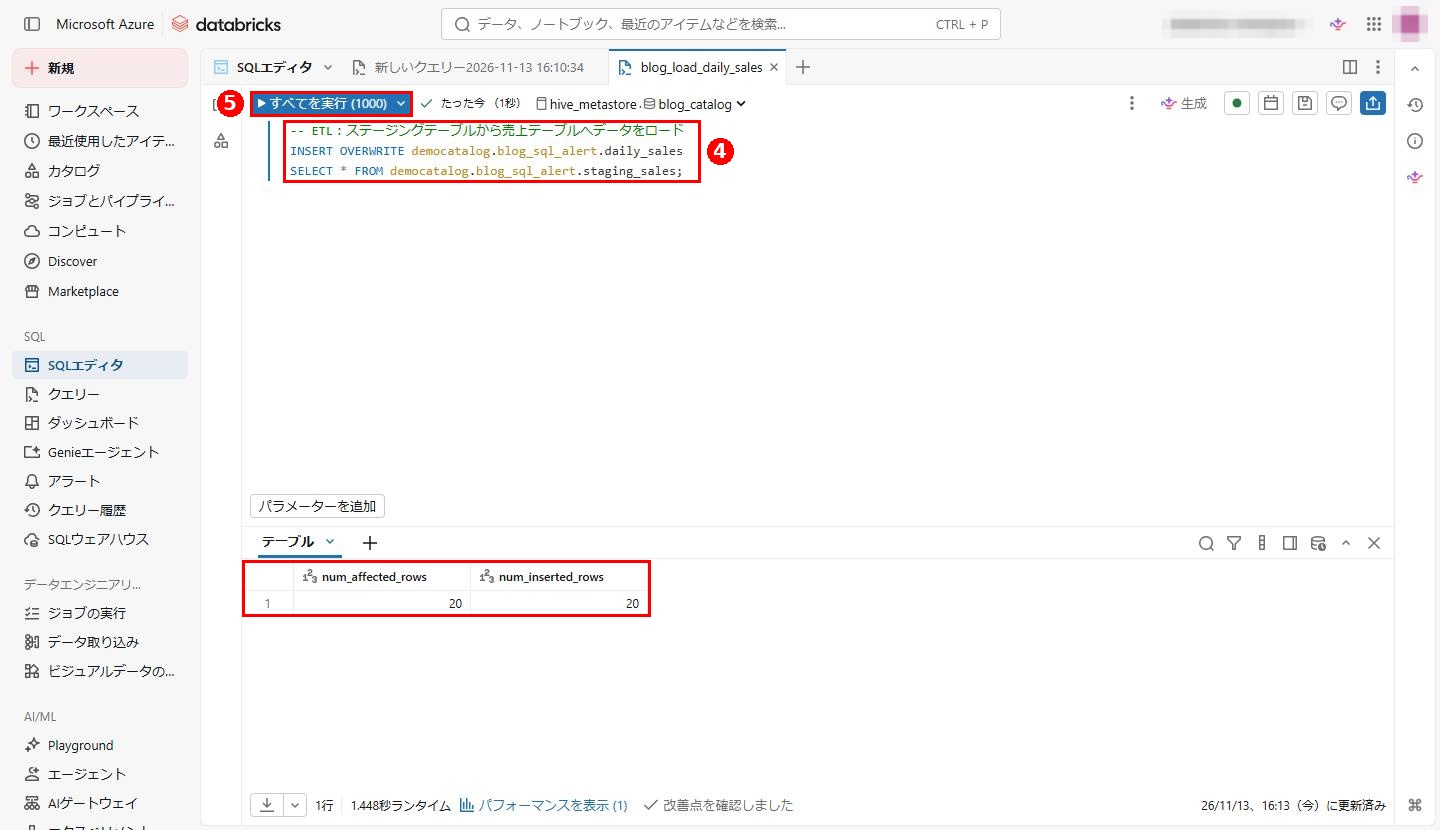
4. ETLステップ用に新しいクエリーを作成し、以下の内容を入力したあと、blog_load_daily_salesという名前で保存します。
|
1 2 3 4 5 |
INSERT OVERWRITE democatalog.blog_sql_alert.daily_sales SELECT * FROM democatalog.blog_sql_alert.staging_sales; |
5. 「すべてを実行」タブをクリックして、行します。
「num_inserted_rows」の値が「20」となり、データが「daily_sales」テーブルに正常に読み込まれたことを確認できます。
このクエリーはジョブのETLタスクとして使用します。
4.2. Databricks SQLアラートの作成
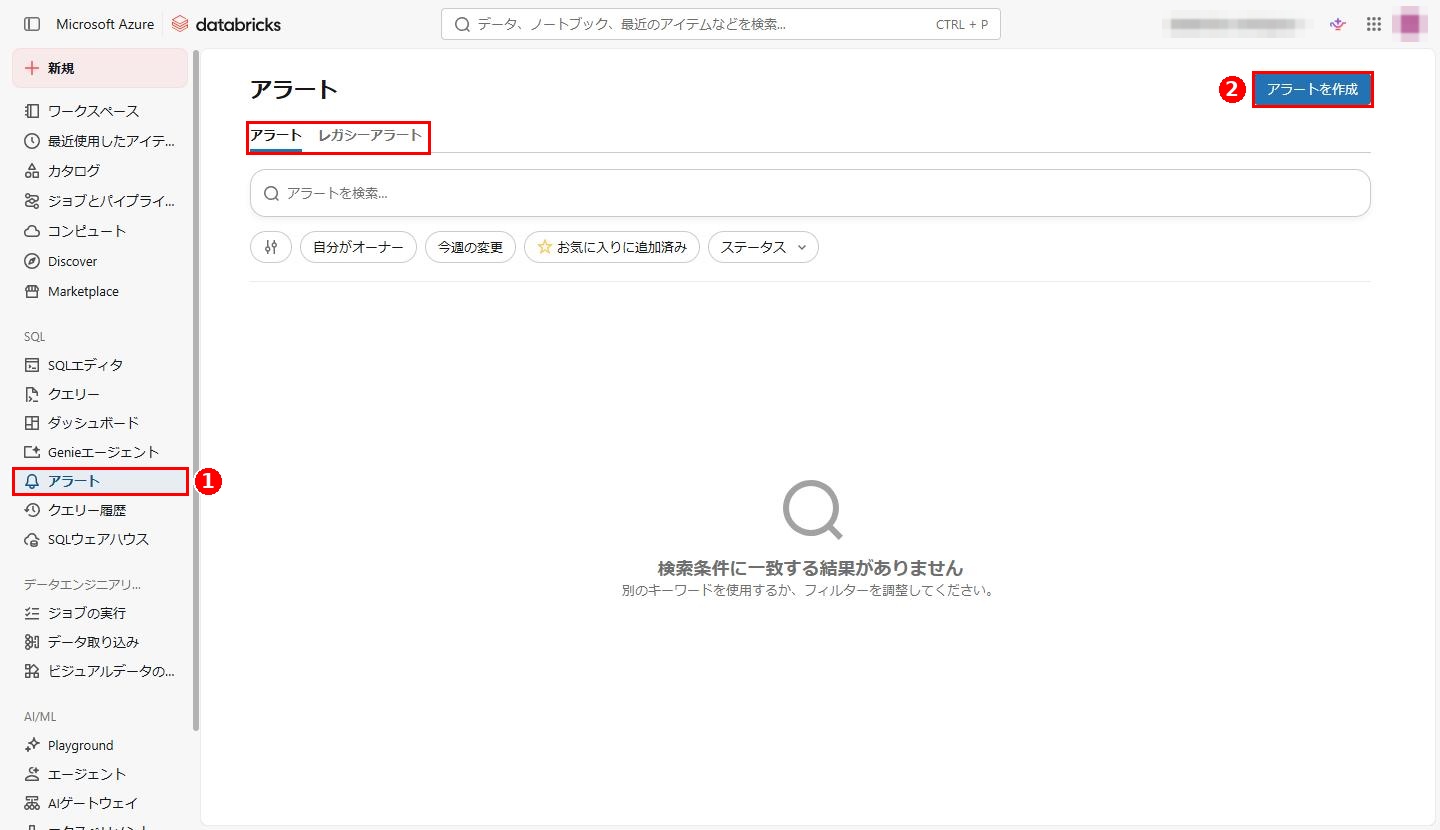
1. 左サイドバーで「アラート」項目を選択します。
「アラート」ページには、最新のアラート用の「アラート」タブとレガシーアラート用の「レガシーアラート」タブがあります。
2. 「アラートを作成」ボタンをクリックして新しいアラートを作成します。
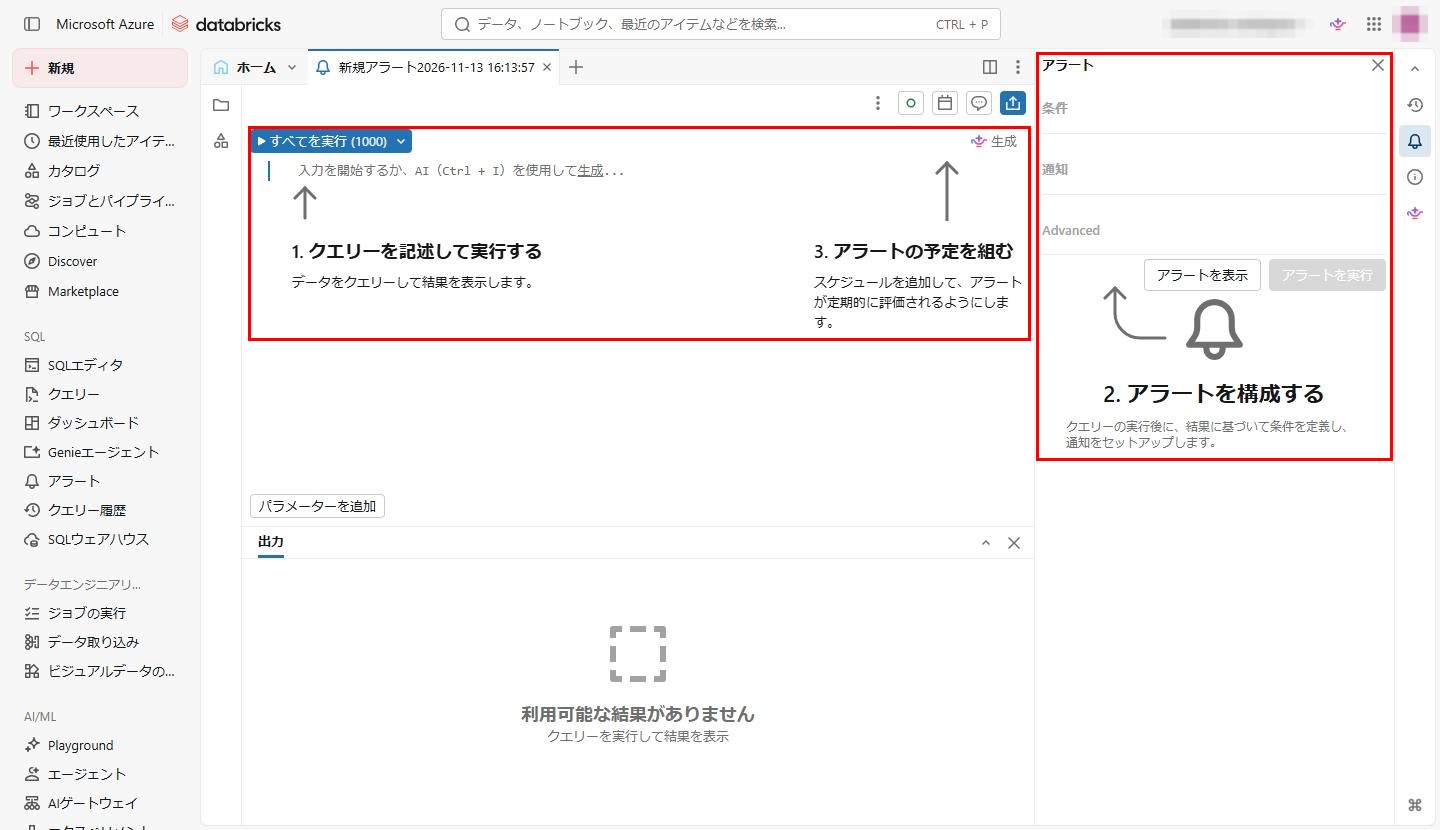
アラートの作成画面が表示されます。
この画面は、左側のクエリー編集エリア、および右側の「アラート」パネルで構成されています。
アラートの作成は、次の3つのステップで行います。
・クエリーを作成して実行する。
・条件と通知を設定する。
・必要に応じた評価スケジュールを設定する。
本記事では、アラートをジョブで評価するため、スケジュールは設定する必要はありません。
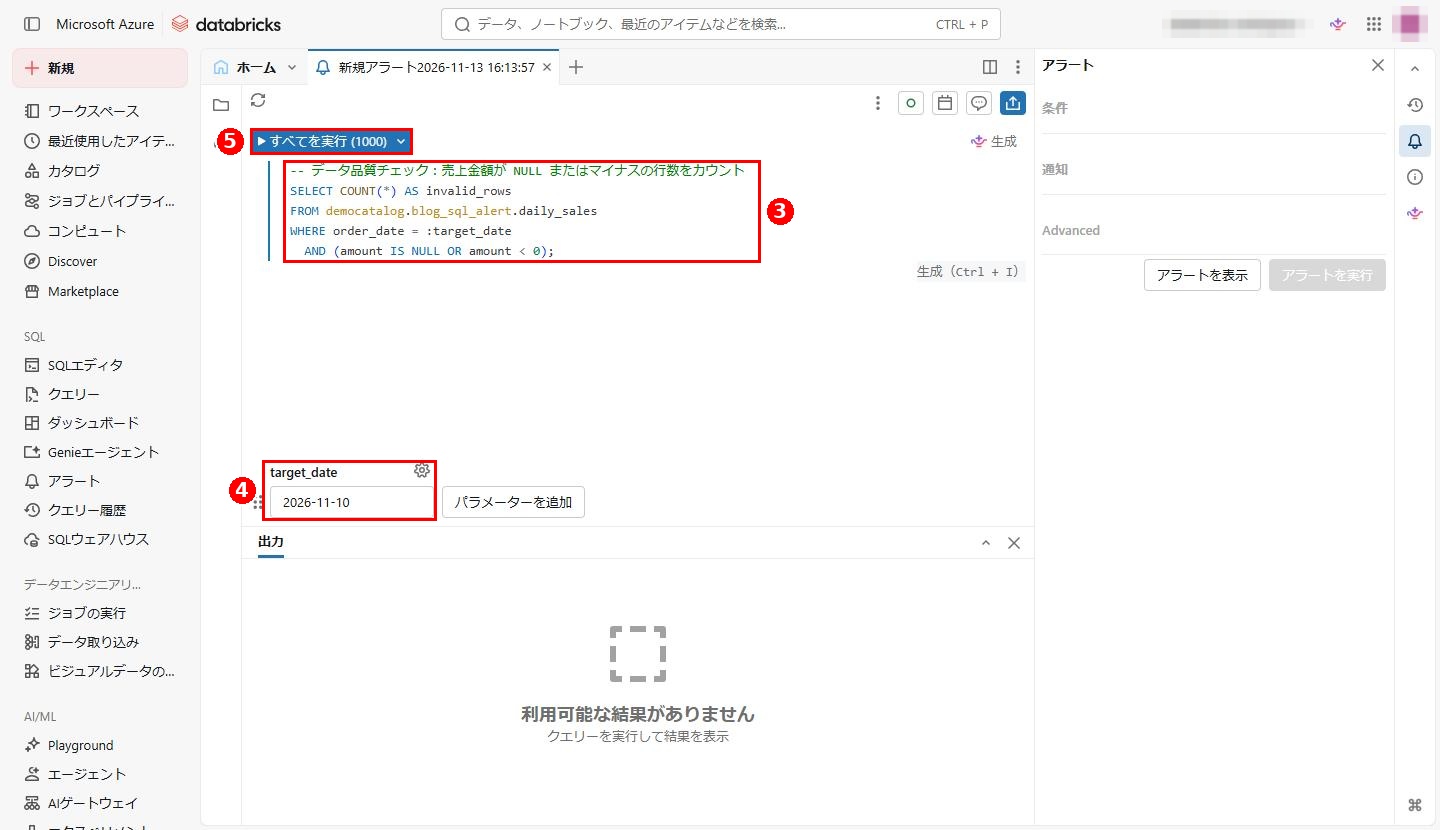
3. クエリーの編集エリアに以下のクエリーを貼り付けます。指定した日付で「amount」が「NULL」またはマイナスの行数をカウントするクエリーです。
|
1 2 3 4 |
SELECT COUNT(*) AS invalid_rows FROM democatalog.blog_sql_alert.daily_sales WHERE order_date = :target_date AND (amount IS NULL OR amount < 0); |
4. 下部に「target_date」パラメーターが自動で表示されます。値に「2026-11-10」を入力します。
5. 「すべてを実行」タブをクリックします。
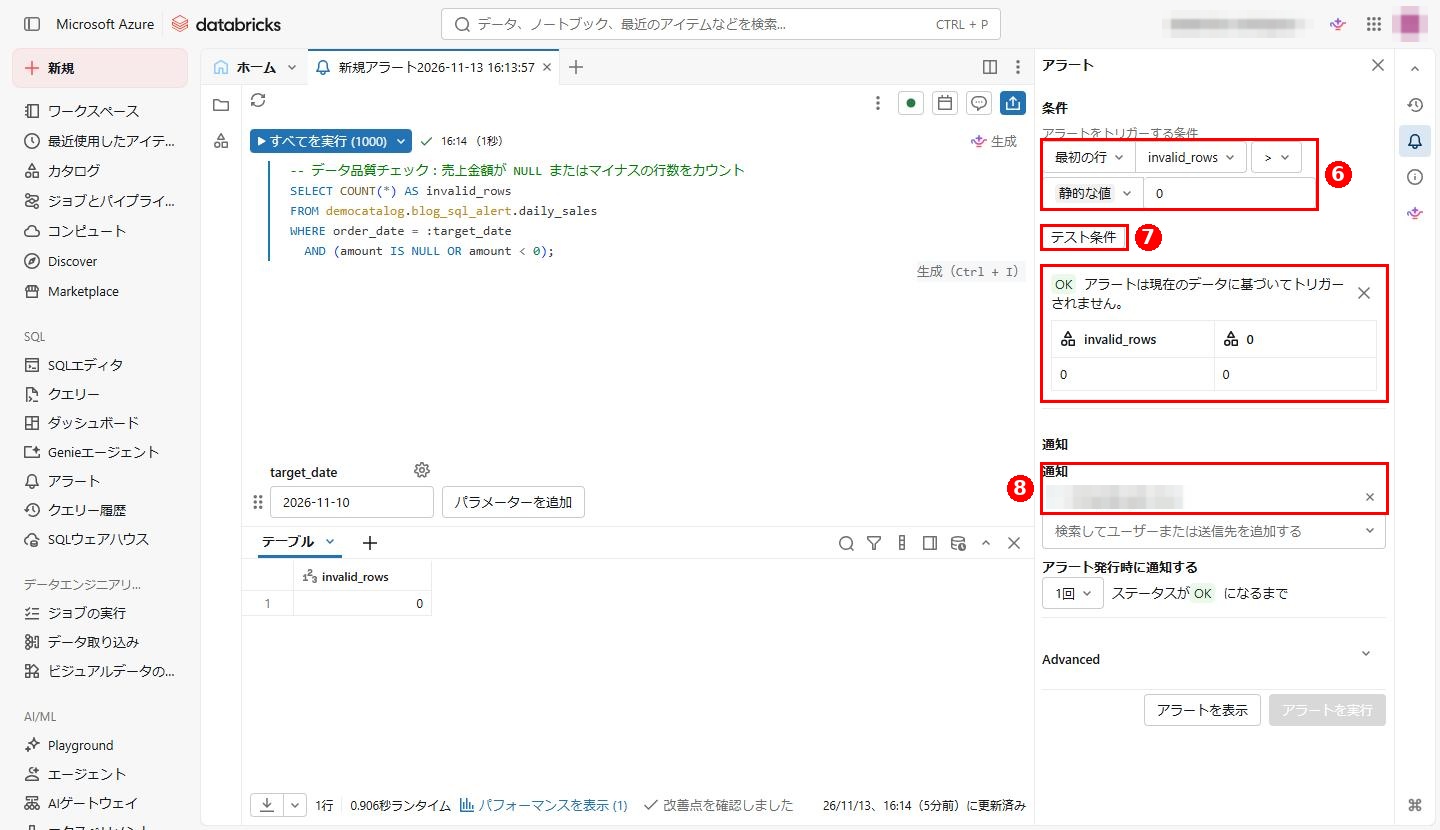
6. 「アラート」パネルの「条件」で、以下のように設定します。
・行:「最初の行」
・列:invalid_rows
・演算子:>
・「静的な値」:0
不正な行が1行以上ある場合、アラートのステータスは「TRIGGERED」に変わります。
7. 「テスト条件」をクリックして条件を確認します。
現在のデータでは、結果が「OK」となります。
8. 「通知」で、通知を受け取るユーザーまたは受信者を選択します。
※アラートの「通知」はデフォルトの受信者一覧です。この一覧は、アラート独自のスケジュールで実行する場合、およびSQLアラートタスクの「サブスクライバー」が未設定の場合に使用されます。
SQLアラートタスクで「サブスクライバー」が設定されている場合は(4.4項参照)、ジョブの実行時には、タスク側で設定した受信者一覧が使用されます。
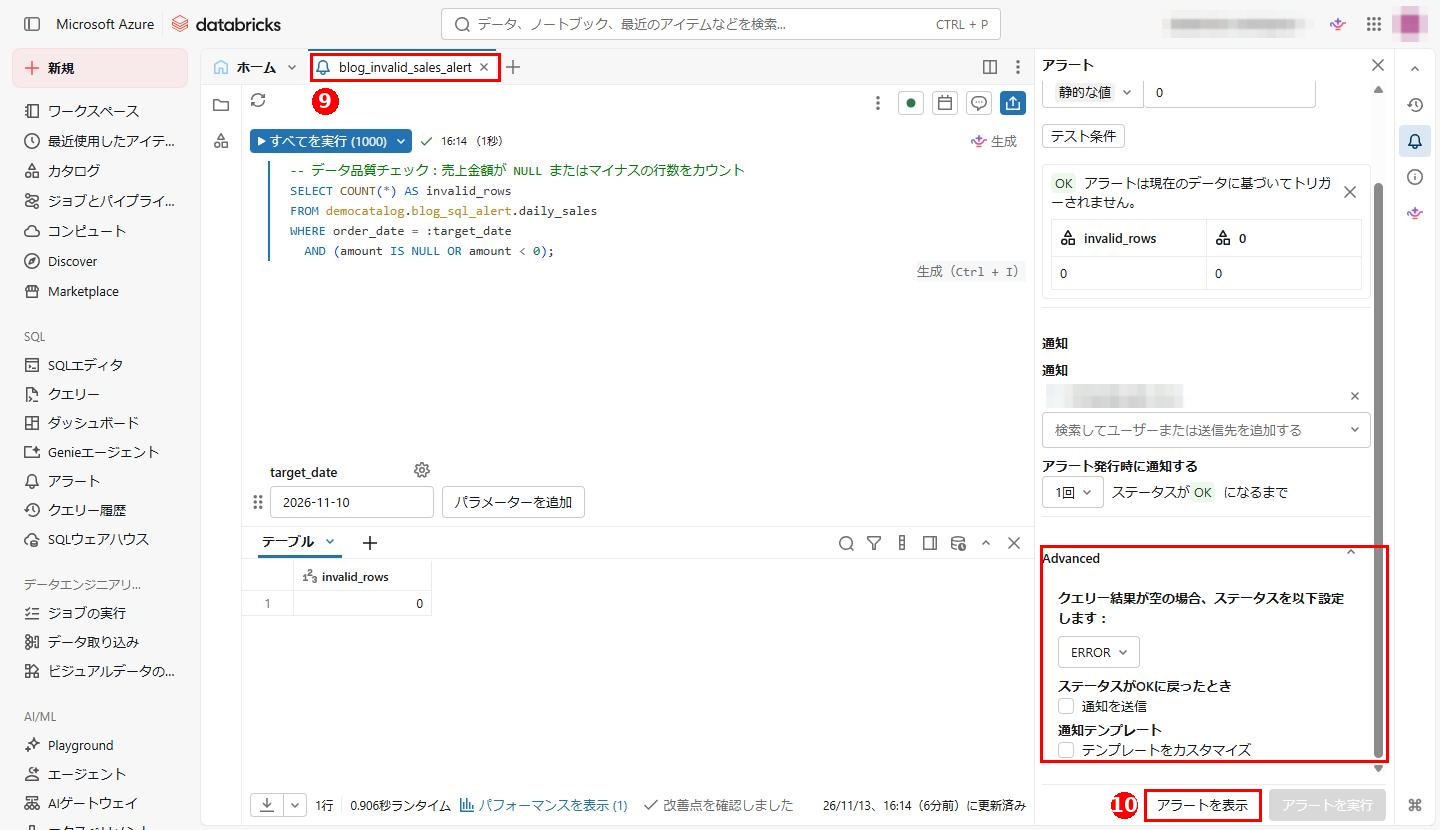
「Advanced」では、以下を追加設定を行うことができます。
- 「クエリー結果が空の場合」:クエリーが1行も返さなかった場合のステータスを設定します。デフォルトは「ERROR」です。
- 「ステータスがOKに戻ったとき」:アラートのステータスが「OK」に戻った際に通知を送信するかどうかを設定します。
- 「通知テンプレート」:通知内容をカスタマイズします。テンプレートはタスク側ではなく、アラートで設定します。
9. タブ名をダブルクリックし、アラート名を「blog_invalid_sales_alert」に変更します。アラートはユーザーのフォルダーに保存されます。
10. 「アラートを表示」をクリックして、アラートの詳細ページを開きます。
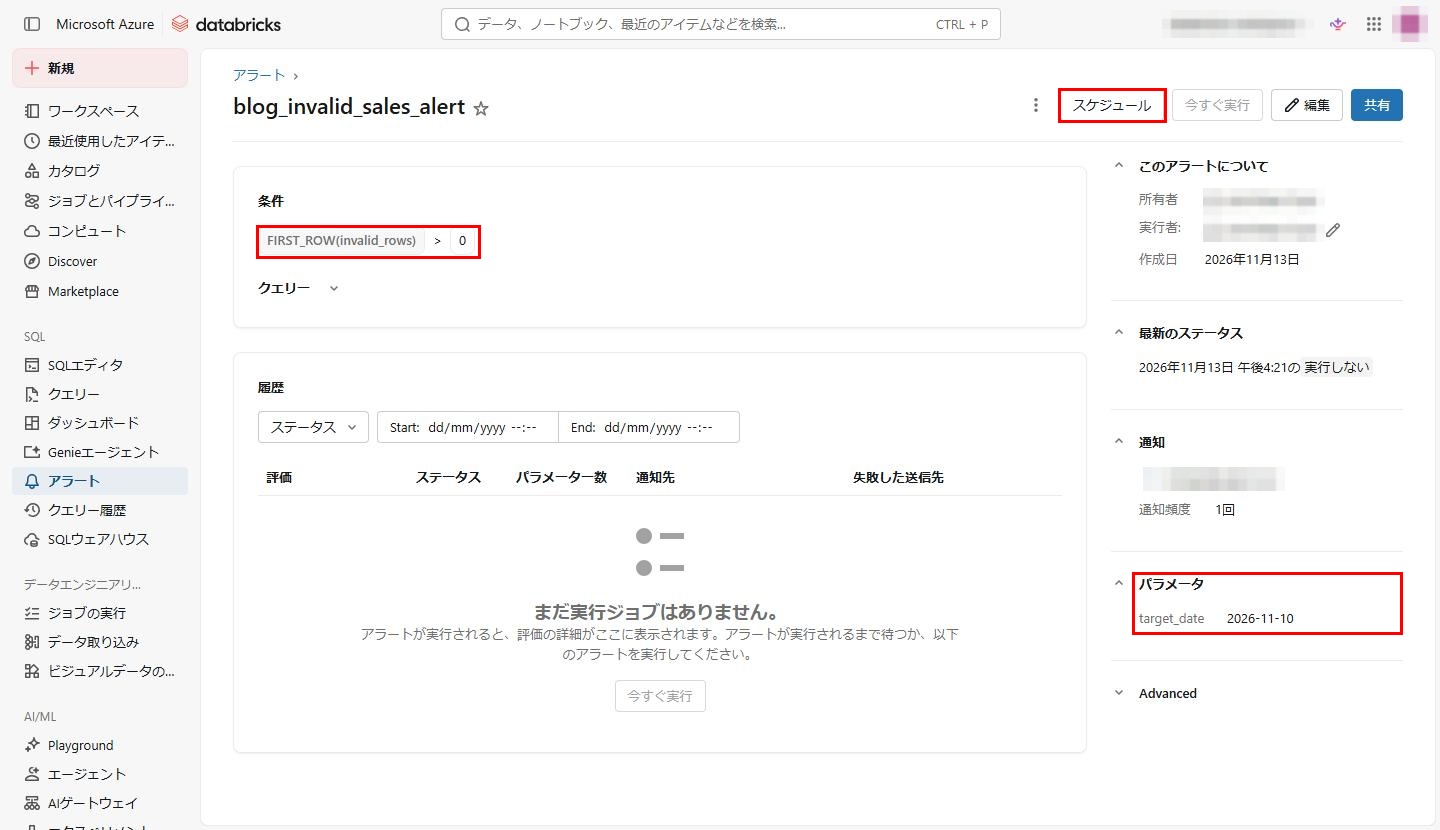
アラートの詳細ページには、条件、通知の受信者、「target_date」パラメーターのデフォルト値が表示されます。
「スケジュール」ボタンでは、アラートを定期的に評価するためのスケジュールを設定できます。本記事では、アラートをジョブで評価するため、ここではスケジュールを設定しません。
4.3. ジョブでのSQLアラートタスクの設定
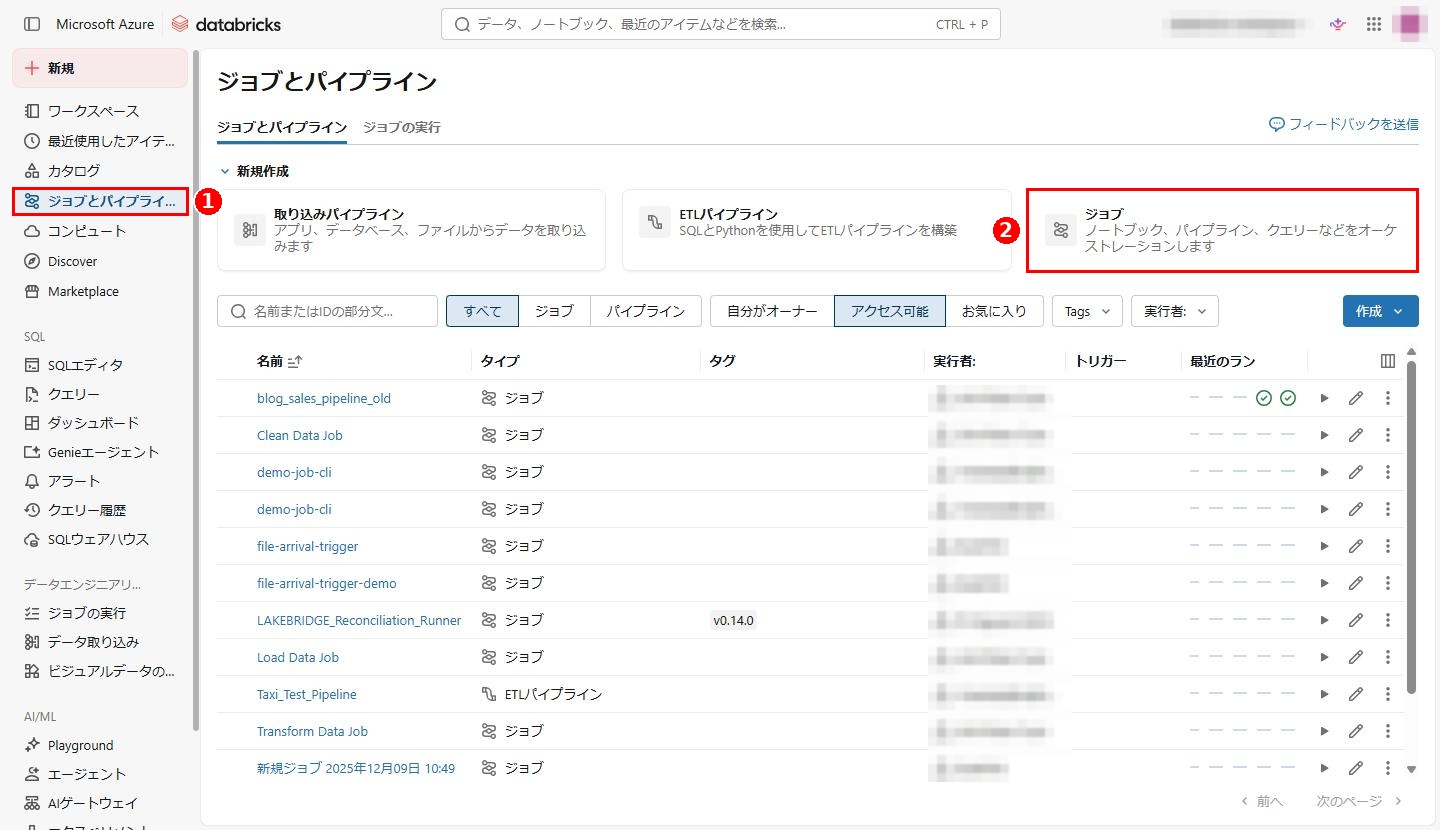
1. サイドバーで「ジョブとパイプライン」項目を選択します。
2. 「新規作成」の「ジョブ」カードをクリックします。新しいジョブが作成されるので、ジョブ名をクリックして「blog_sales_pipeline」に変更します。
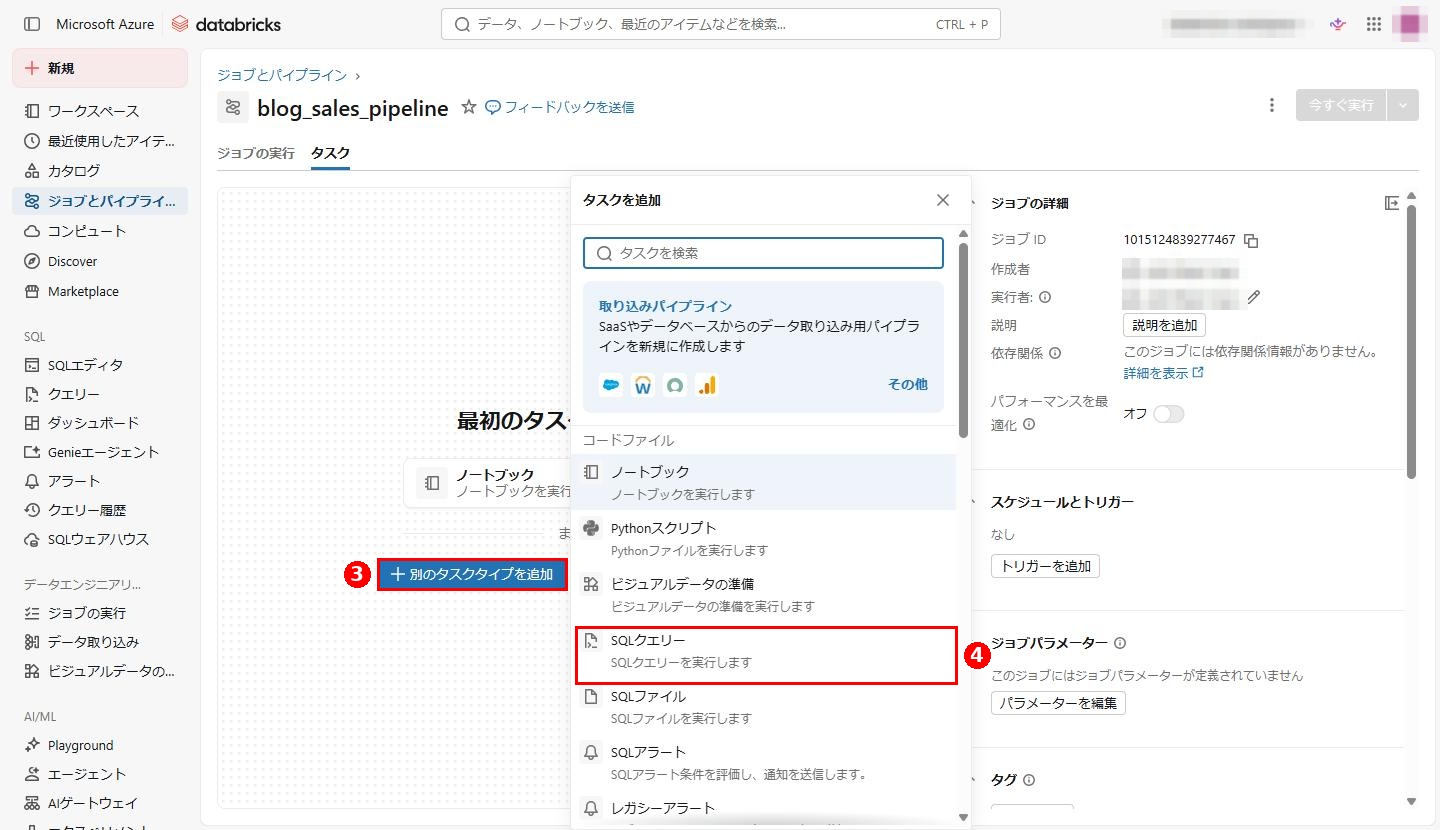
3. 「別のタスクタイプを追加」ボタンをクリックします。
4. 「SQLクエリー」を選択してETLタスクを作成します。
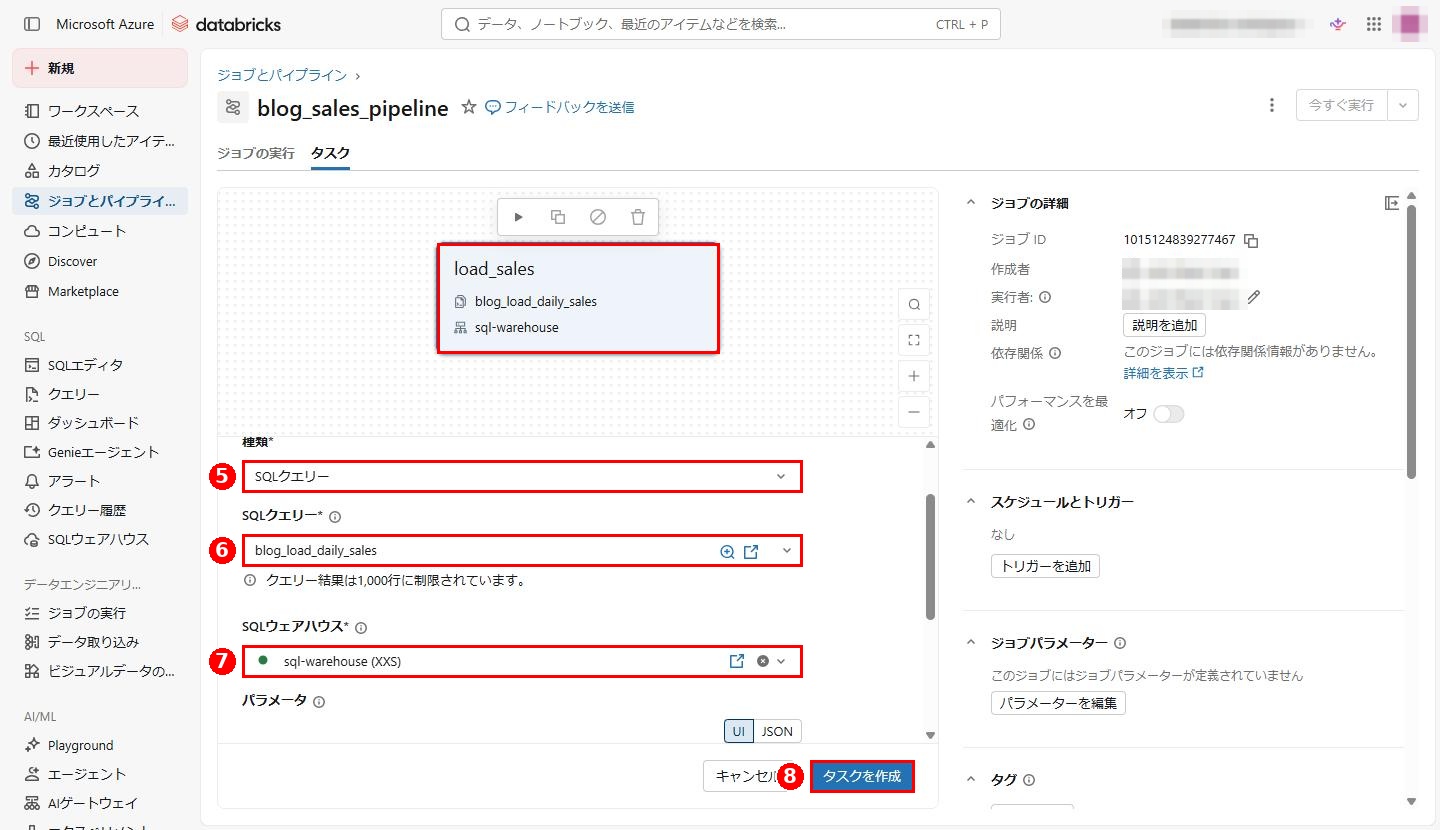
「タスク名」にload_salesを入力し、以下を設定します。
5. 「種類」で「SQLクエリー」を選択します。
6. 「SQLクエリー」で「blog_load_daily_sales」を選択します。
7. 「SQLウェアハウス」でサーバーレスまたはProタイプのSQLウェアハウスを選択します。
8. 「タスクを作成」をクリックします。
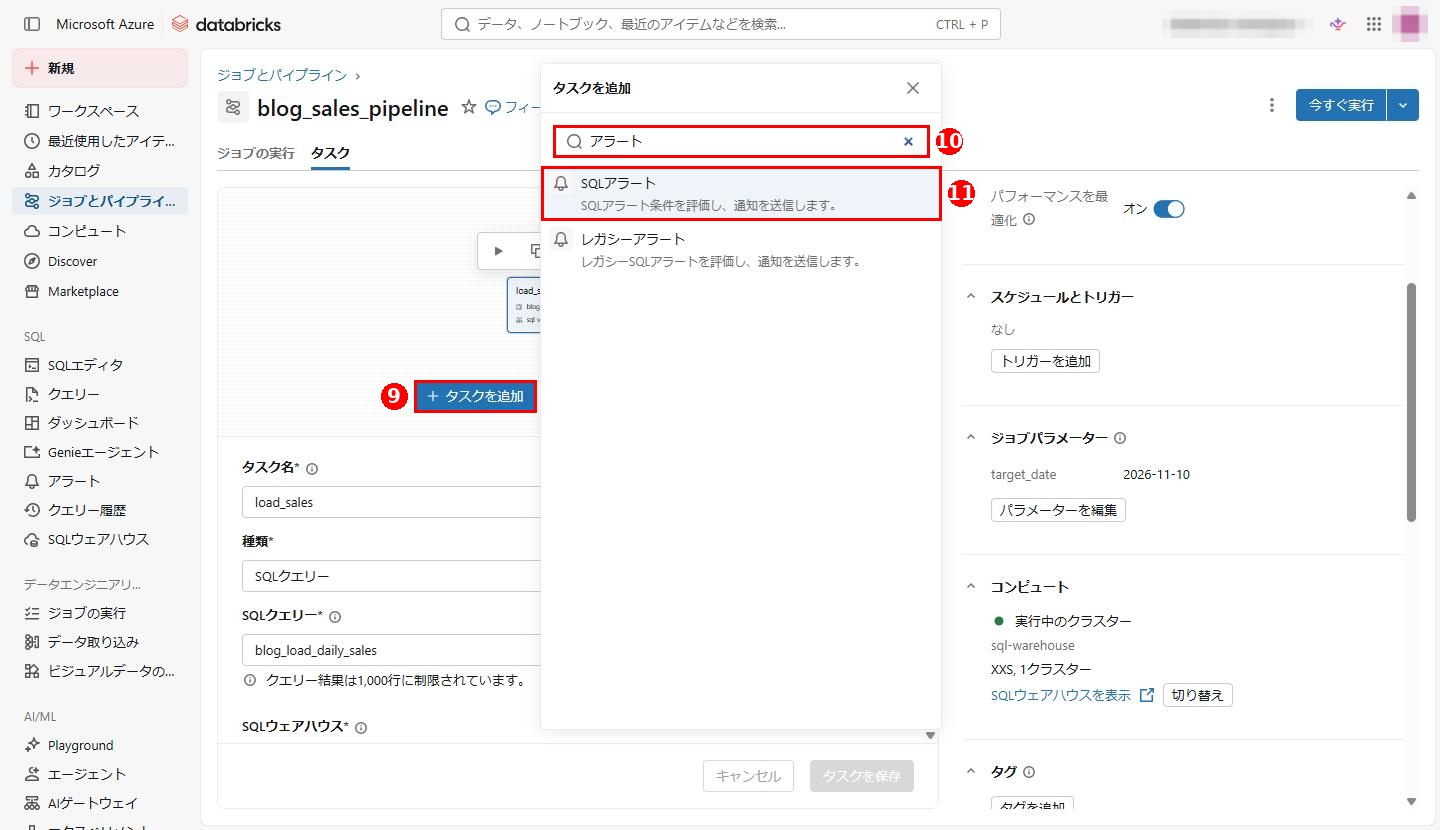
9. 「タスクを追加」をクリックします。
10. 検索ボックスに「アラート」と入力します。
11. 「SQLアラート」を選択します。
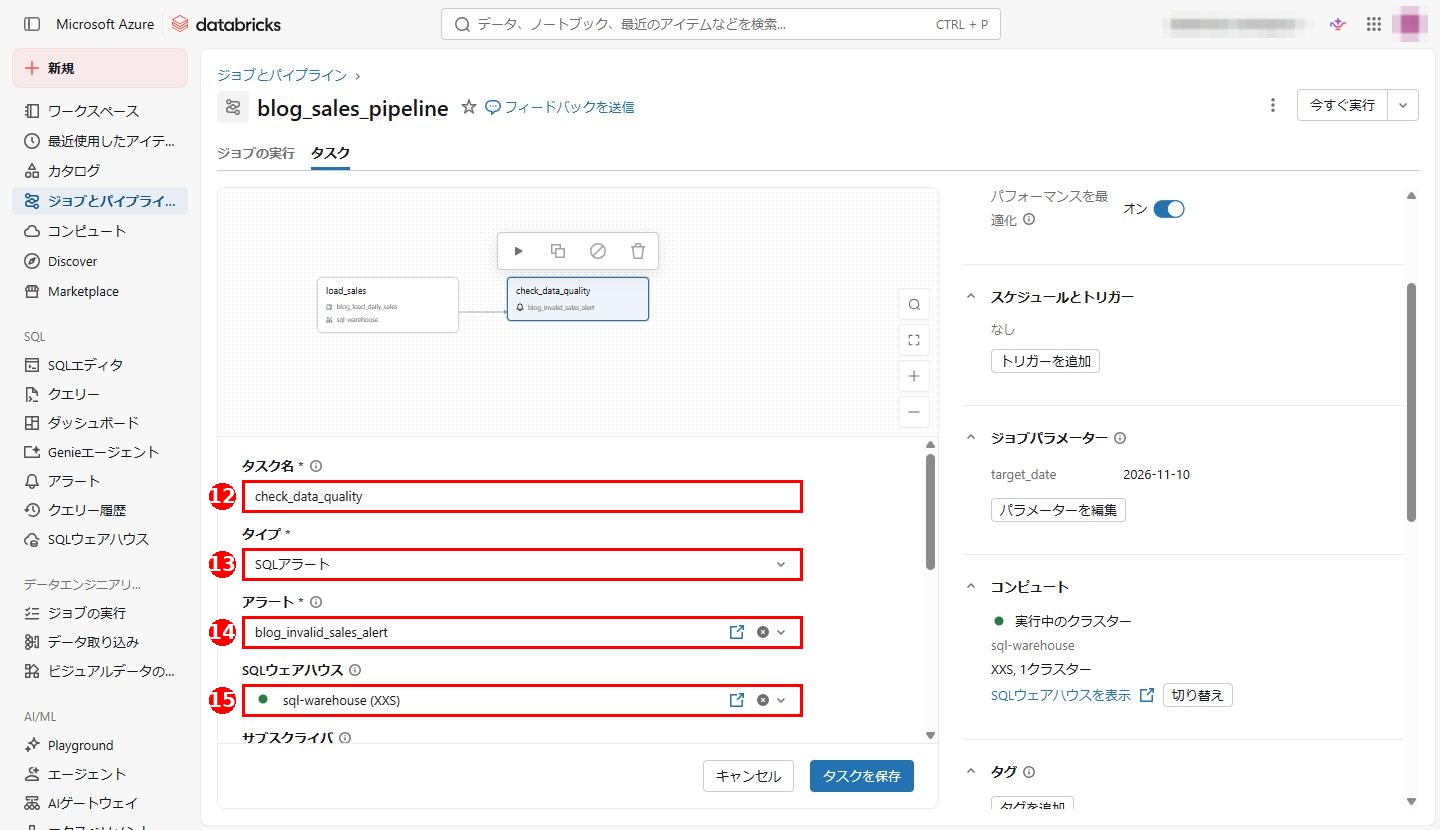
SQLアラートタスクを以下のように設定します。
12. 「タスク名」にcheck_data_qualityを入力します。
13. 「タイプ」で「SQLアラート」を選択します。
14. 「アラート」でblog_invalid_sales_alertを選択します。
15. 「SQLウェアハウス」でSQLウェアハウスを選択します。この項目は任意で、未設定の場合はアラートに設定されたSQLウェアハウスが使用されます。
新しいタスクには自動的にタスク「load_sales」への依存関係が設定されるため、アラートは常にETLの完了後に評価されます。
4.4. ジョブパラメーターからアラートクエリーへのパラメーターの引き渡し
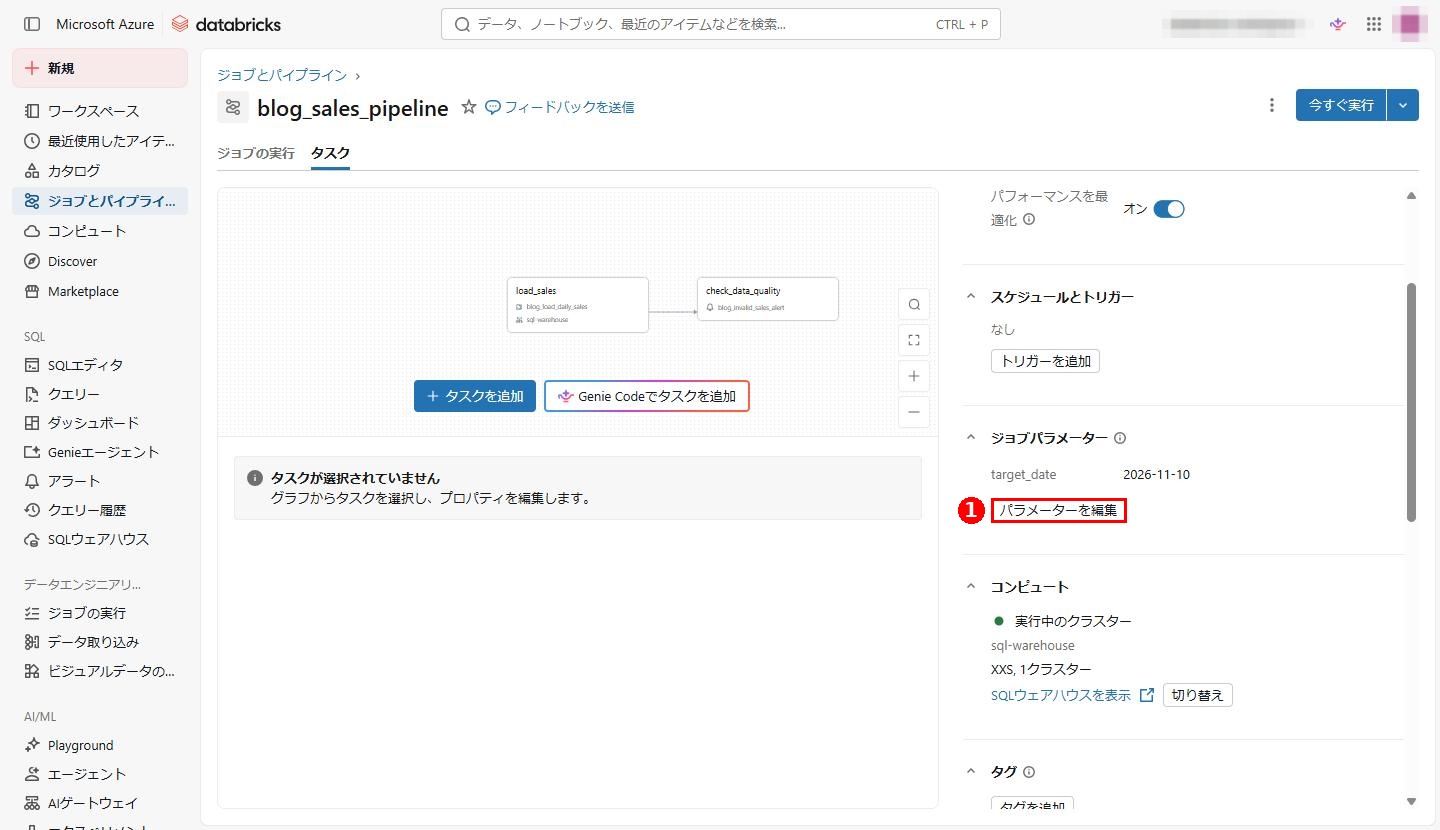
アラートを編集せずにチェック対象の日付を変更できるように、ジョブパラメーターからアラートの「target_date」パラメーターに日付を渡します。
1. ジョブの右側パネルの「ジョブパラメーター」で、「パラメーターを編集」をクリックします。
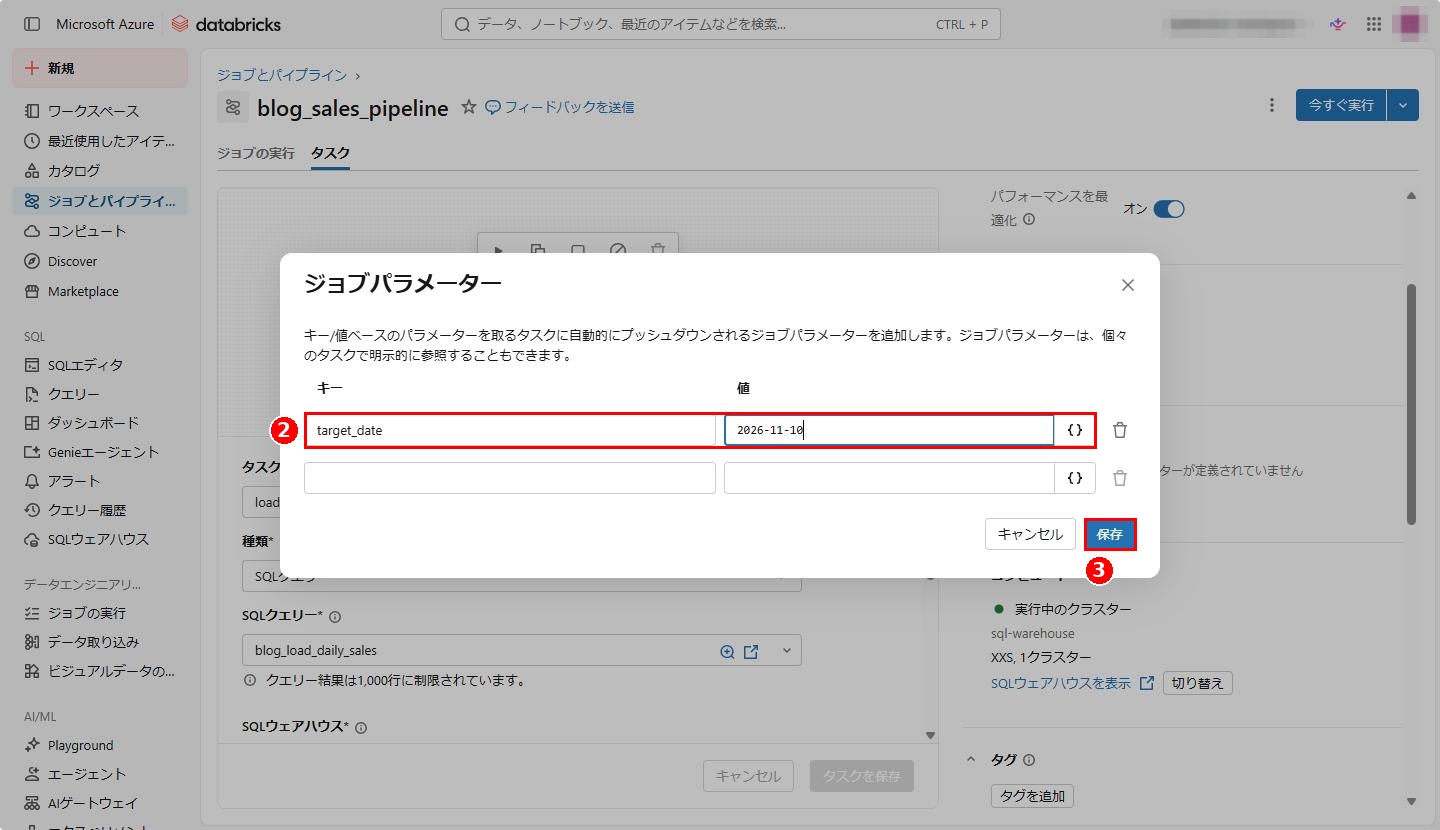
2. 「キー」に「target_date」、「値」に「2026-11-10」を入力します。
3. 「保存」をクリックします。
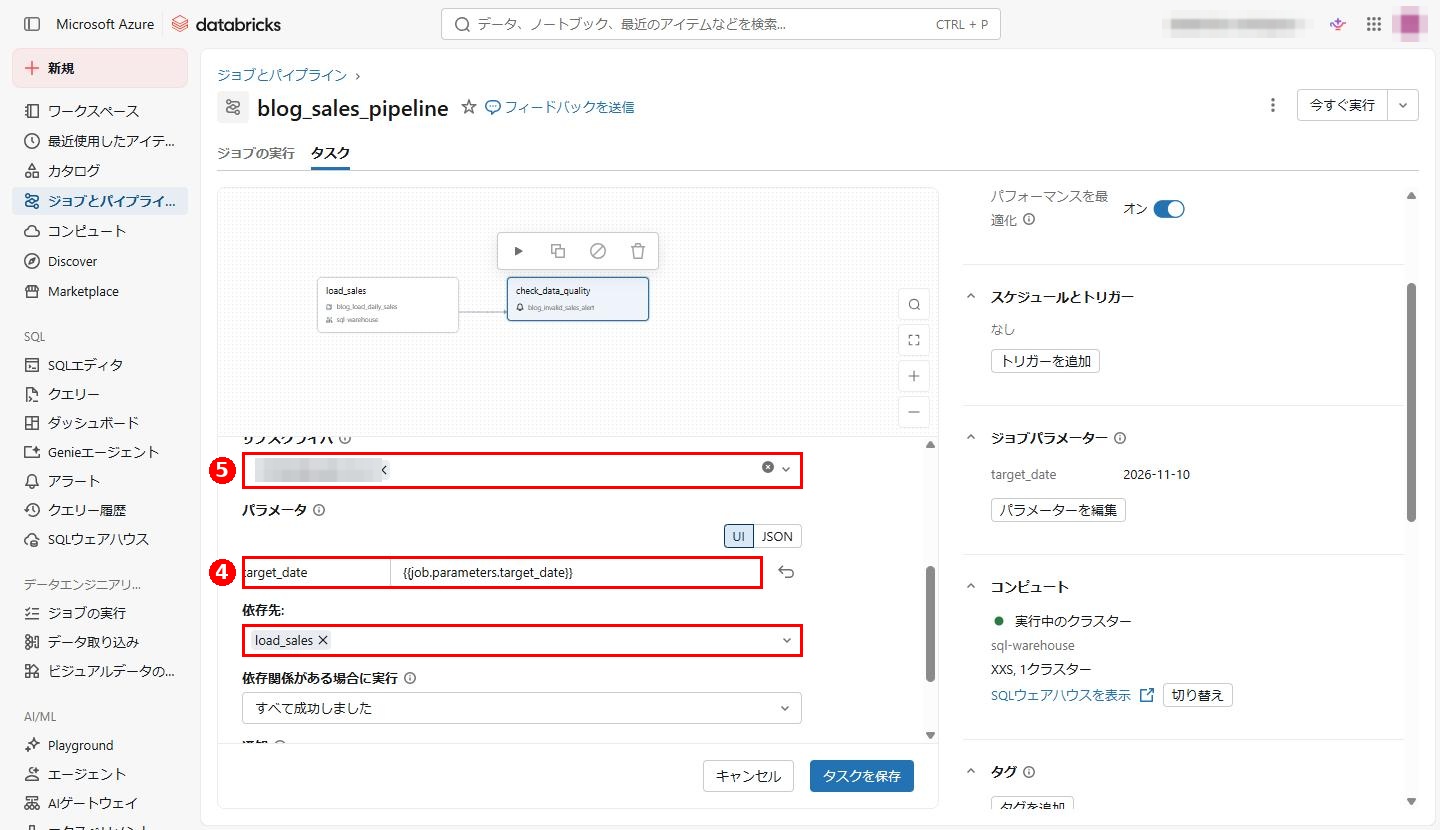
「check_data_quality」タスクに戻り、下にスクロールします。
4. 「パラメーター」で、target_dateの値を以下に置き換えます。
|
1 |
{{job.parameters.target_date}} |
5. 「サブスクライバー」で受信者を選択します。この項目設定は任意です。
設定した場合、ここで選択したユーザーまたは通知先が、ジョブ実行時のアラートの評価結果を受け取ります。未設定の場合は、アラートの「通知」に設定された受信者に通知されます(4.2項の手順8を参照)。
※受信者の管理は1か所で十分です。ジョブ内で実行するアラートの場合は、タスクの「サブスクライバー」で受信者を設定することを推奨します。
パラメーターの値には、単一の値のみを指定できます。アラートのいずれのパラメーターとも一致しないキーは無視され、タスクの実行はそのまま維持されます。
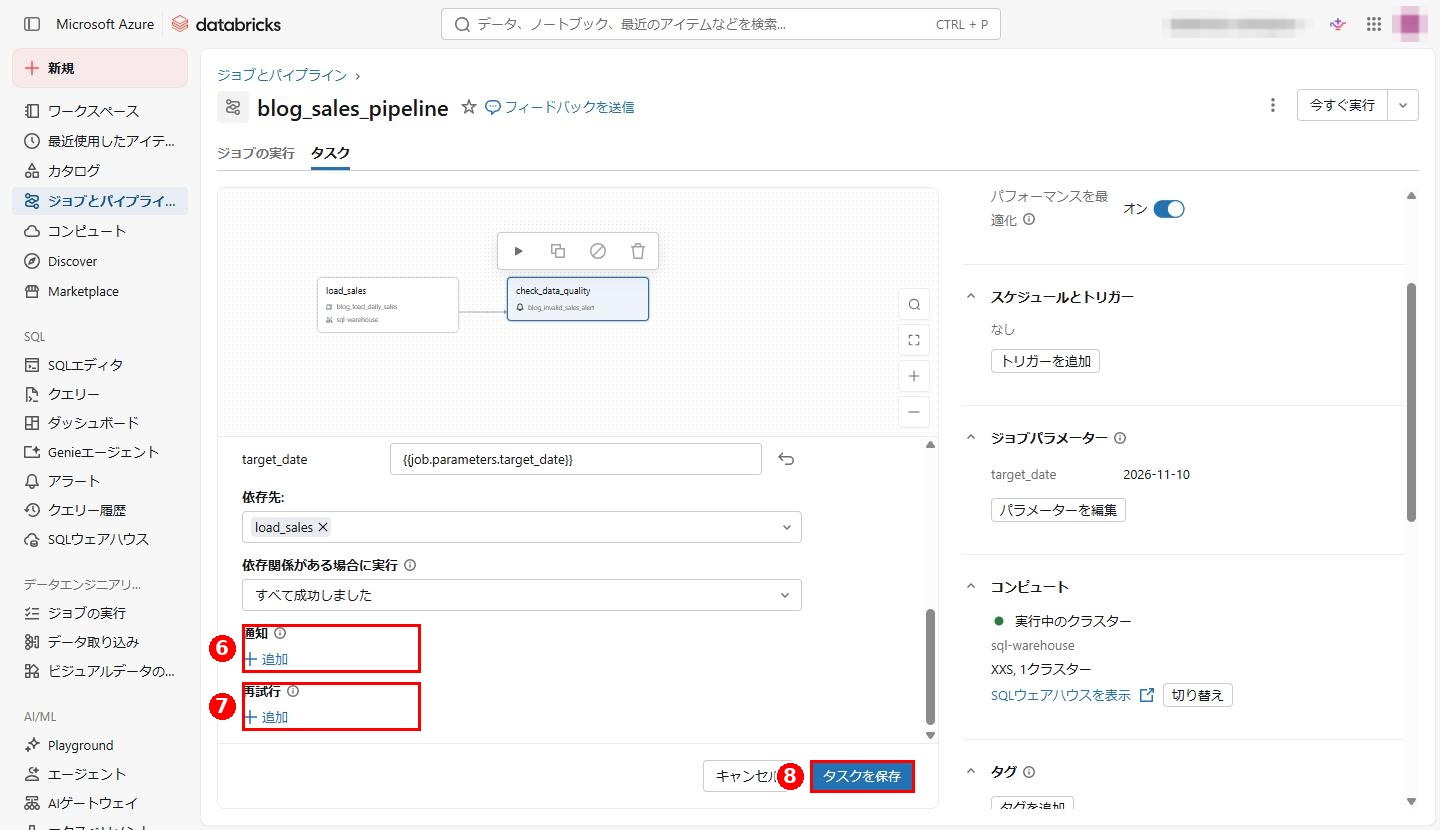
6. 必要に応じて、「通知」でメールまたはWebhookを追加し、タスクの開始時・成功時・失敗時に通知を受け取ります。
7. 必要に応じて、「再試行」で一時的なエラー時の自動再実行回数を追加します。
8. 「タスクを保存」をクリックして設定を完了します。
※タスクの「通知」は、タスクの実行状態のみを通知します。アラートのステータスが「TRIGGERED」になった場合でも、タスク自体は成功として扱われるため、「通知」から不正なデータに関するアラートは送信されません。
データ異常に関する通知は、タスクの「サブスクライバー」に設定した受信者に送信されます。タスクの「サブスクライバー」が未設定の場合は、アラートの「通知」に設定した受信者に送信されます。
4.5. ジョブの実行および「OK」・「TRIGGERED」の場合の結果確認
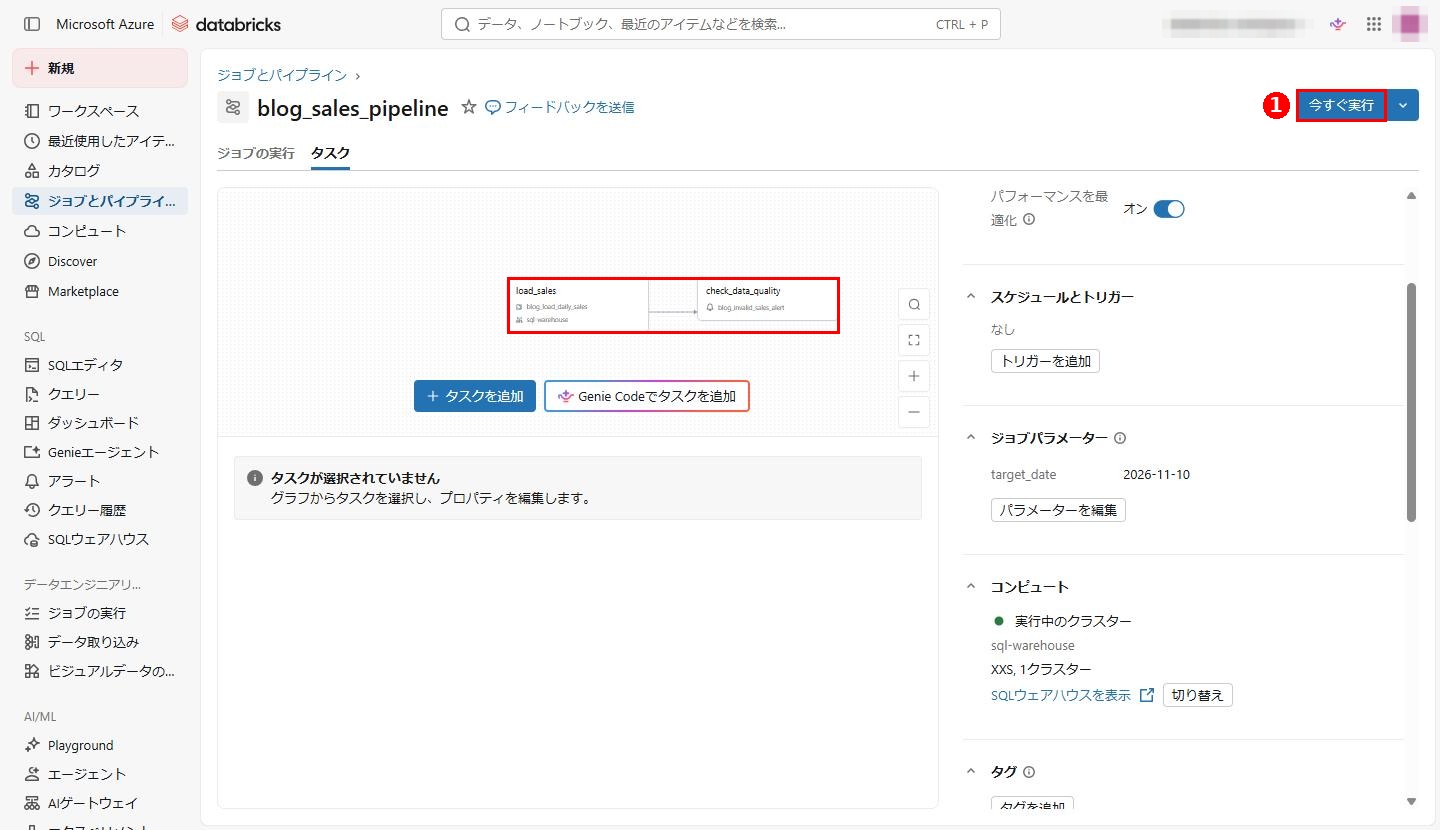
「load_sales」および「check_data_quality」タスクの2つで構成されるジョブが作成されました。
1. 「今すぐ実行」をクリックし、正常なデータでジョブを1回目実行します。
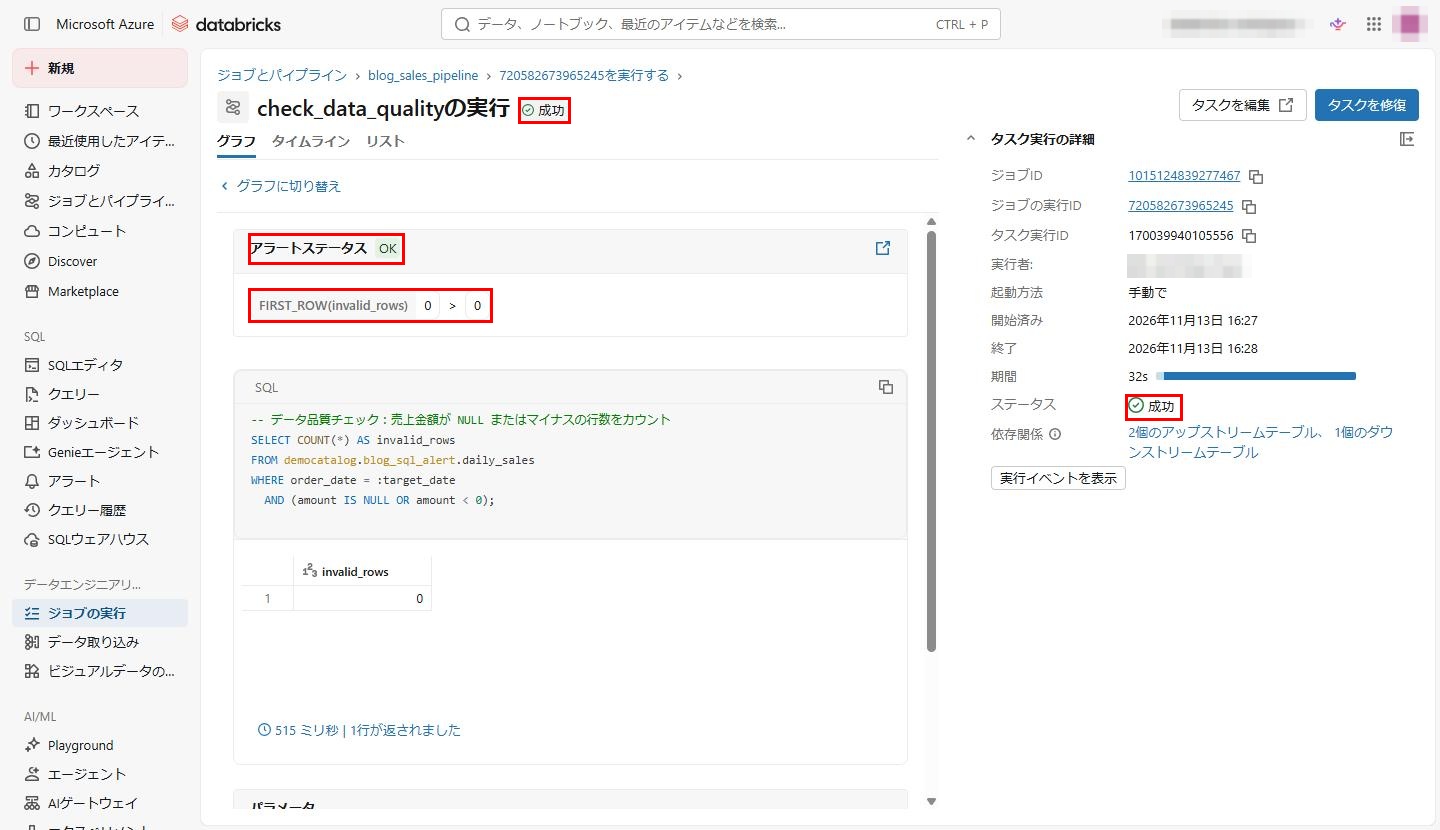
ジョブの実行が完了したら、「ジョブの実行」タブを開き、今回の実行の「check_data_quality」タスクを選択します。
「invalid_rows」が「0」であり、「0より大きい」という条件を満たさないため、「アラートステータス」は「O」K」となります。タスクのステータスは「成功」です。
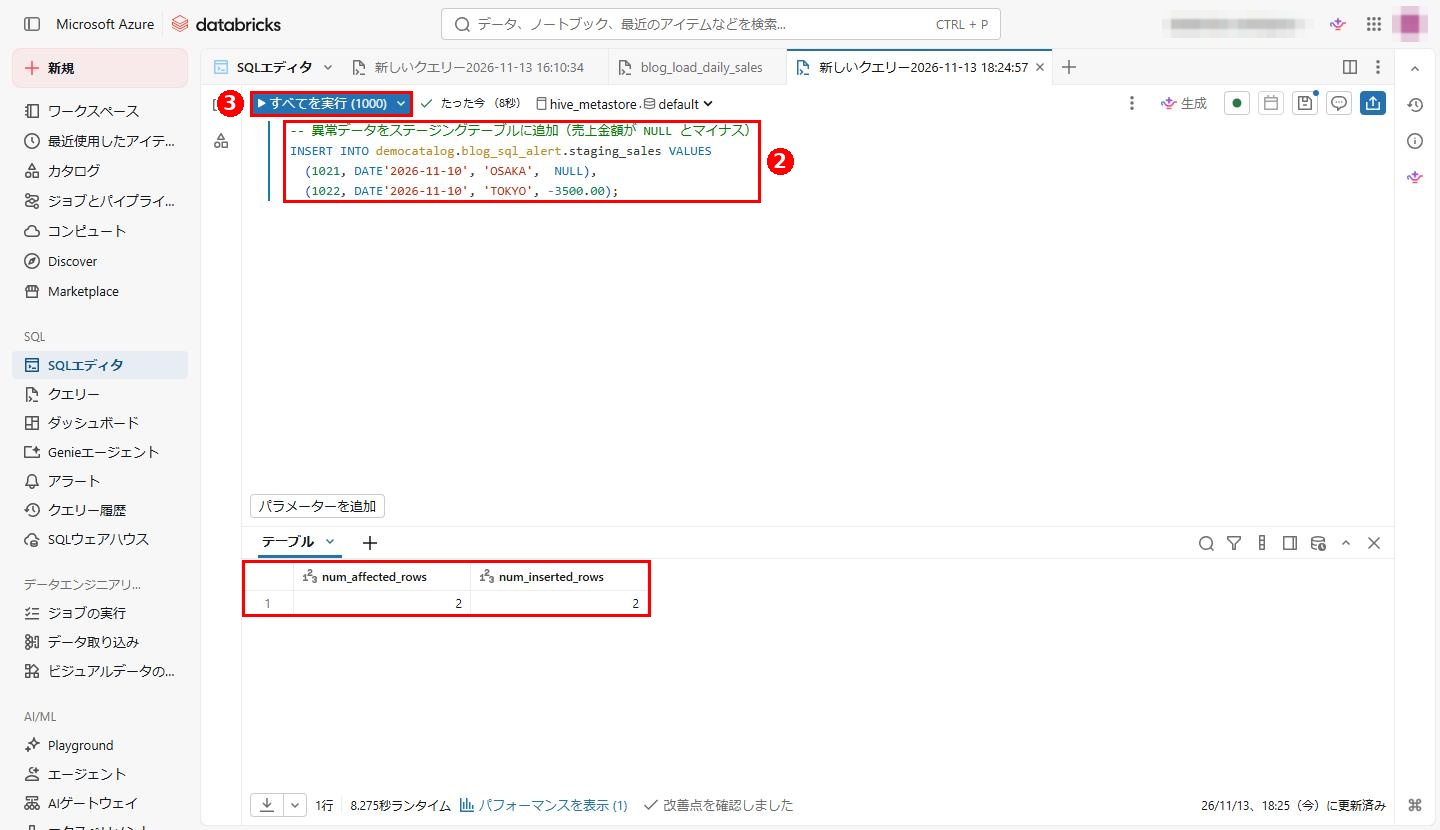
異常データを再現するため、「amount」が「NULL」とマイナスの2行をステージングテーブルに追加します。
2. SQLエディタで新しいクエリーを開き、以下のSQLを貼り付けます。
|
1 2 3 4 5 6 7 |
INSERT INTO democatalog.blog_sql_alert.staging_sales VALUES (1021, DATE'2026-11-10', 'OSAKA', NULL), (1022, DATE'2026-11-10', 'TOKYO', -3500.00); |
3. 「すべてを実行」をクリックします。
4. ジョブに戻り、手順1と同様に「今すぐ実行」をクリックして2回目を実行します。
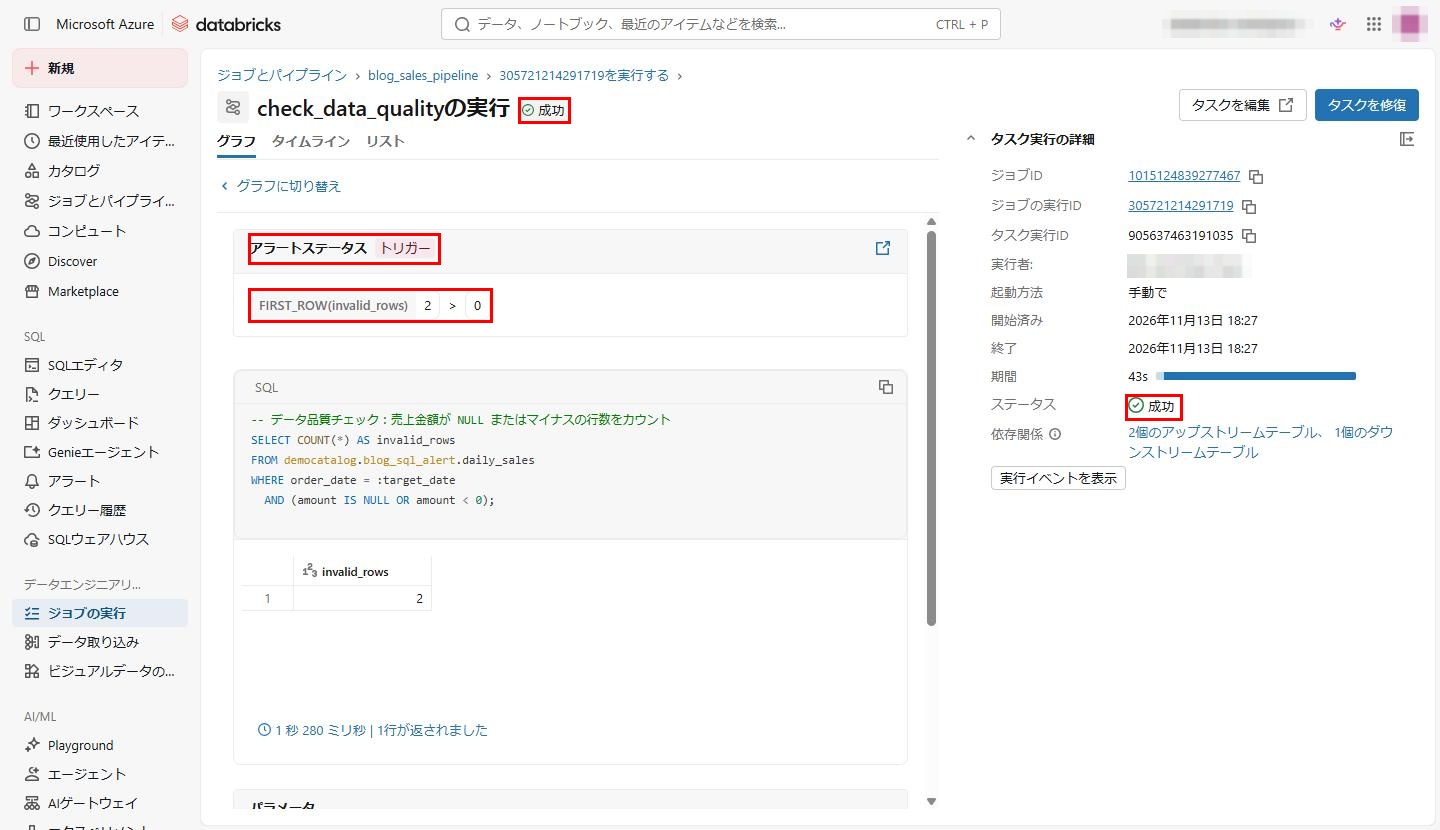
2回目の実行の「check_data_quality」タスクを開きます。
今回は「invalid_rows」が「2」となったため、「アラートステータス」は「トリガー」、つまり「TRIGGERED」になりました。ただし、タスクのステータスは「成功」のままです。
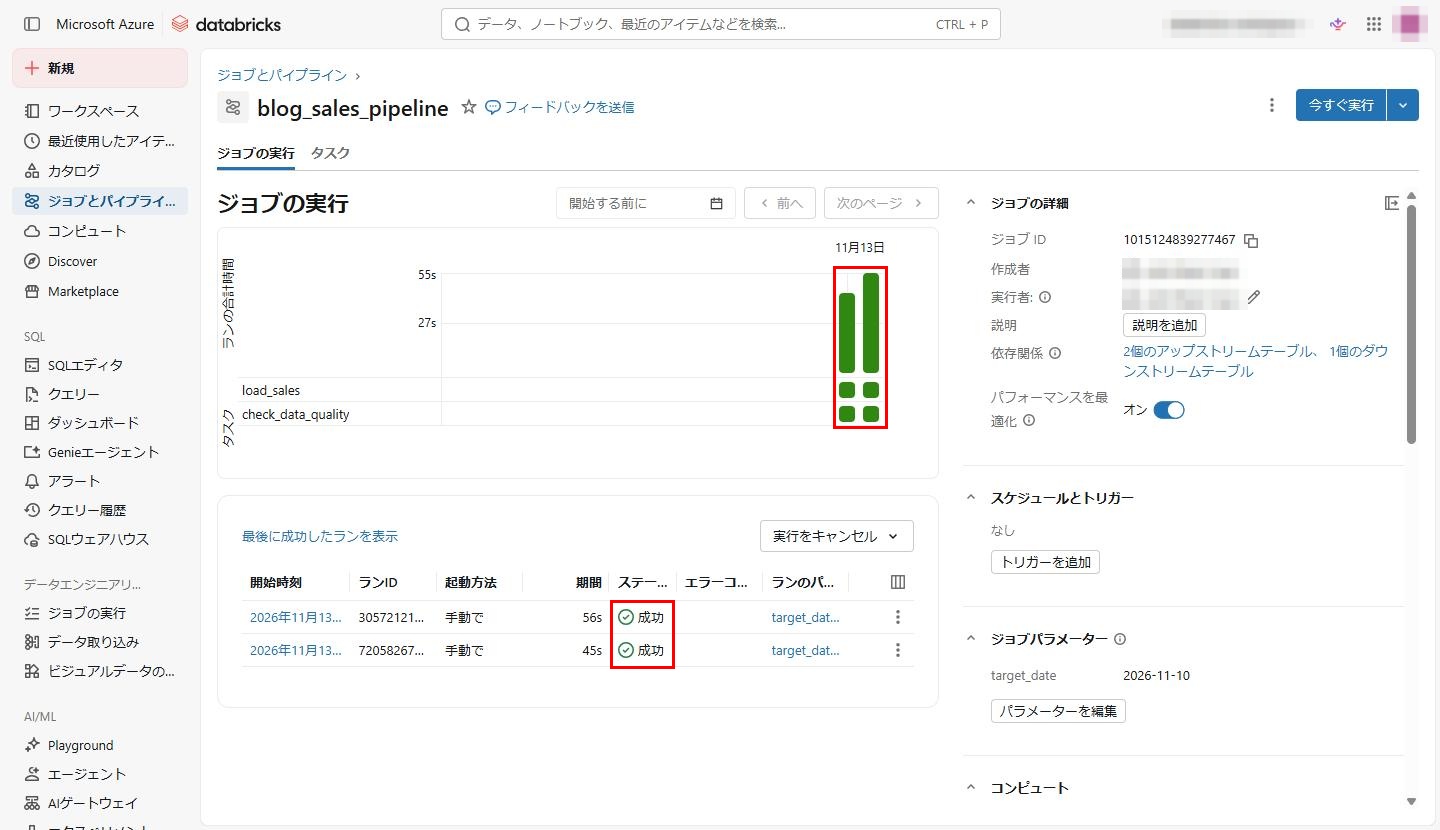
「ジョブの実行」タブでは、2回目の実行でアラートが異常データを検知したにもかかわらず、2回とも「成功」と表示されています。
これは、SQLアラートタスクがアラートを評価して結果を受信者に送信するだけで、条件を満たしてもジョブを失敗させないためです。
※詳しくは4.6項で説明します。
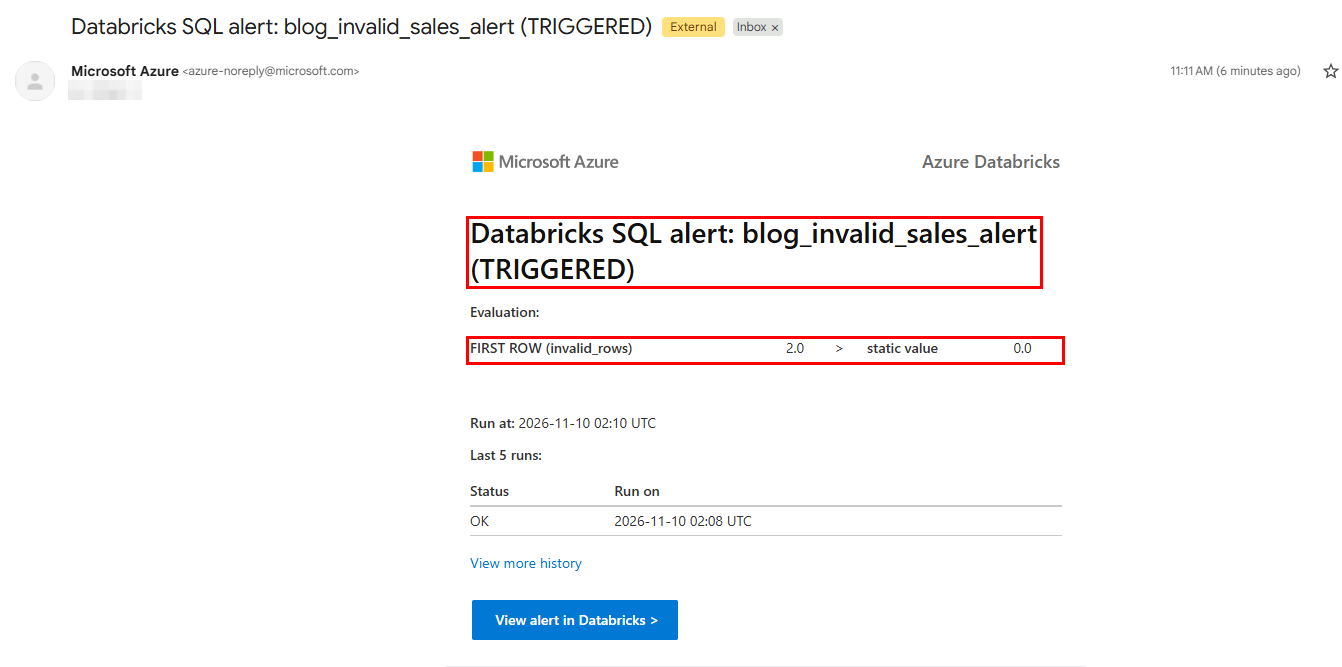
登録した受信者のメールボックスを確認します。
件名が「Databricks SQL alert: blog_invalid_sales_alert (TRIGGERED)」のメールが届いています。
メールには、評価結果「FIRST ROW (invalid_rows) 2.0 > 0.0」、実行日時、直近の評価履歴、Databricks上のアラートへのリンクが表示されます。
4.6. SQLアラートタスクの動作の仕組み
SQLアラートタスクが実行されると、Databricksは選択したSQLウェアハウス上でアラートのクエリーを実行し、結果に対して条件を評価し、評価結果に基づいて受信者に通知を送信します。アラートのステータスとタスクのステータスは以下のように決まります。
| ケース | アラートのステータス | タスクのステータス |
|---|---|---|
| 条件を満たさない(例:invalid_rowsが0) | OK | Succeeded |
| 条件を満たす | TRIGGERED | Succeeded(受信者に通知) |
| 評価時のエラー(例:SQLウェアハウスに接続できない、クエリーのエラー) | ERROR | Failed |
- タスクの評価は、アラートに設定されたスケジュールとは独立して実行されます。ジョブを実行しても、アラートに設定されたスケジュールは変更されません。
- デフォルトではタスクによってパイプラインの実行がブロックされることはありません:アラートが「TRIGGERED」になってもタスクは「Succeeded」となり、後続のタスクも実行されます。
パイプラインを停止させる場合には、追加の設計が必要です。例えば、アラートタスクの後に「If/else条件」タスクを配置し、次の条件を設定します。
{{tasks.check_data_quality.output.alert_state}} == TRIGGERED
そのうえで、後続のタスクを「false」分岐にのみ接続します。または、「true」分岐に「raise_error()」を呼び出す専用のSQLタスクを接続してジョブを失敗させます。 - アラート自体のクエリーに「raise_error()」を記述しないでください。この関数はランタイムエラーを発生させるため、データ条件の評価結果として「TRIGGERED」が返されるのではなく、クエリーの実行エラーによってアラートが「ERROR」となり、タスクも「Failed」になります。
- 参考資料:Dynamic value references、raise_error function
4.7. 使用上の制限事項および推奨事項
制限事項
- SQLアラートタスクは最新のDatabricks SQLアラートのみをサポートします。レガシーアラートを使用する場合には、「レガシーアラート」タスクを使用するか、最新のアラートに移行する必要があります。
- サーバーレスまたはProタイプのSQLウェアハウスのみ使用できます。
- アラートが「TRIGGERED」になっても、タスクは失敗しません。デフォルトでは、タスクによってパイプラインの実行が停止されることはありません。パイプラインを停止させるには、追加の設計が必要です(4.6項を参照)。
- アラートが「TRIGGERED」になっても、タスクの「通知」から送信されません。これは、タスク自体は成功として扱われるためです。データ異常に関するアラートは、タスクのサブスクライバー、またはタスクのサブスクライバーが未設定の場合はアラートの受信者に送信されます。
- 渡すパラメーターの値は単一の値である必要があります。通知テンプレートのカスタマイズはアラート側でのみ可能です。
推奨事項
- 通知を受け取ったときに追跡しやすいよう、アラートとタスクにはチェックの目的がわかる名前を付けます。
- 処理日など実行ごとに変わる値はジョブパラメーターを使用し、クエリーへのハードコーディングを避けます。
- データのアラートの受信者はタスクのサブスクライバーで管理し、SlackやMicrosoft Teamsなどの通知先を登録して運用チーム全体で受け取れるようにします。タスクの「通知」はジョブの実行エラーの監視に適しています。
- 運用環境に導入する前に、ジョブの実行IDをサービスプリンシパルに設定し、クエリーとアラートの実行IDを確認します(下の表を参照)。
- SQLウェアハウスの起動中などの一時的なエラーに対応するため、タスクに「再試行」を設定します。
- コストの発生を避けるため、SQLウェアハウスの自動停止を有効にし、試行後はウェアハウスを停止します。
本記事ではすべてのステップがジョブ作成者の権限で実行されます。運用環境では、各ステップの実行時IDを明確にし、適切な権限を付与する必要があります。
| 対象 | 実行ID | 必要な権限 |
|---|---|---|
| ジョブ | ジョブのRun as。デフォルトはジョブの作成者で、「ジョブの詳細」パネルで変更できます。 | Run asの変更には、ジョブのCAN MANAGEまたはIS OWNERと、対象サービスプリンシパルのサービスプリンシパルユーザーロールが必要です。 |
| SQLクエリータスクload_sales、SQLアラートタスクcheck_data_quality | クエリー・アラートの共有設定に従います。Run as ownerの場合はクエリー・アラートの所有者のID、Run as viewerの場合はジョブのRun asが使用されます。 | SQLウェアハウスのCAN USE、読み取るテーブルのUSE CATALOG・USE SCHEMA・SELECT、ETLタスクではdaily_salesのMODIFYが必要です。 |
| 通知の受信者 | 対象外 | ユーザーが通知を受け取るには、アラートに対して少なくともCAN RUNが必要です。通知先はワークスペース管理者が作成します。 |
- Databricksは本番ジョブのRun asをサービスプリンシパルにすることを推奨しています。クエリーやアラートがRun as ownerの場合、ジョブのRun asに関係なく所有者の権限で実行されます。所有者が削除された場合は、ワークスペース管理者がアラートの所有権を移管します。
- 参考:Manage identities, permissions, and privileges for Lakeflow Jobs、Access control lists
5. まとめ
SQLアラートタスクを使用すると、データ品質チェックをLakeflow Jobsに直接組み込むことができます。1つのSQLクエリーと1つの条件だけで、ETLの直後にデータのロジック上の問題を自動で検知し、担当者にアラートを送信できるため、手動での確認やエンドユーザーによる発見を待つ必要がなくなります。
注意点として、TRIGGEREDの状態ではタスクは失敗しないため、デフォルトではSQLアラートタスクはパイプラインを停止しません。停止させるには、アラートのステータスに基づくIf/else条件タスクなどの追加設計が必要です。運用環境に導入する際は、ジョブのRun asをサービスプリンシパルに設定し、クエリーとアラートの実行IDを確認してください。
参考ドキュメント:SQL alert task for jobs – Azure Databricks | Microsoft Learn
今回の記事が少しでも皆さんの新しい知識や業務のご参考になれば幸いです。
双日テックイノベーションでは、Azure Databricksの環境構築パッケージを用意しています。
Azure DatabricksやAzure活用、マイクロソフト製品の活用についてご相談事がありましたら是非お問い合わせください!
Azure Databricks連載記事のまとめはこちら
 お問い合わせはこちら
この記事を読んだ方へのオススメコンテンツはこちら
この記事を書いた人
